
第一印象与入门体验
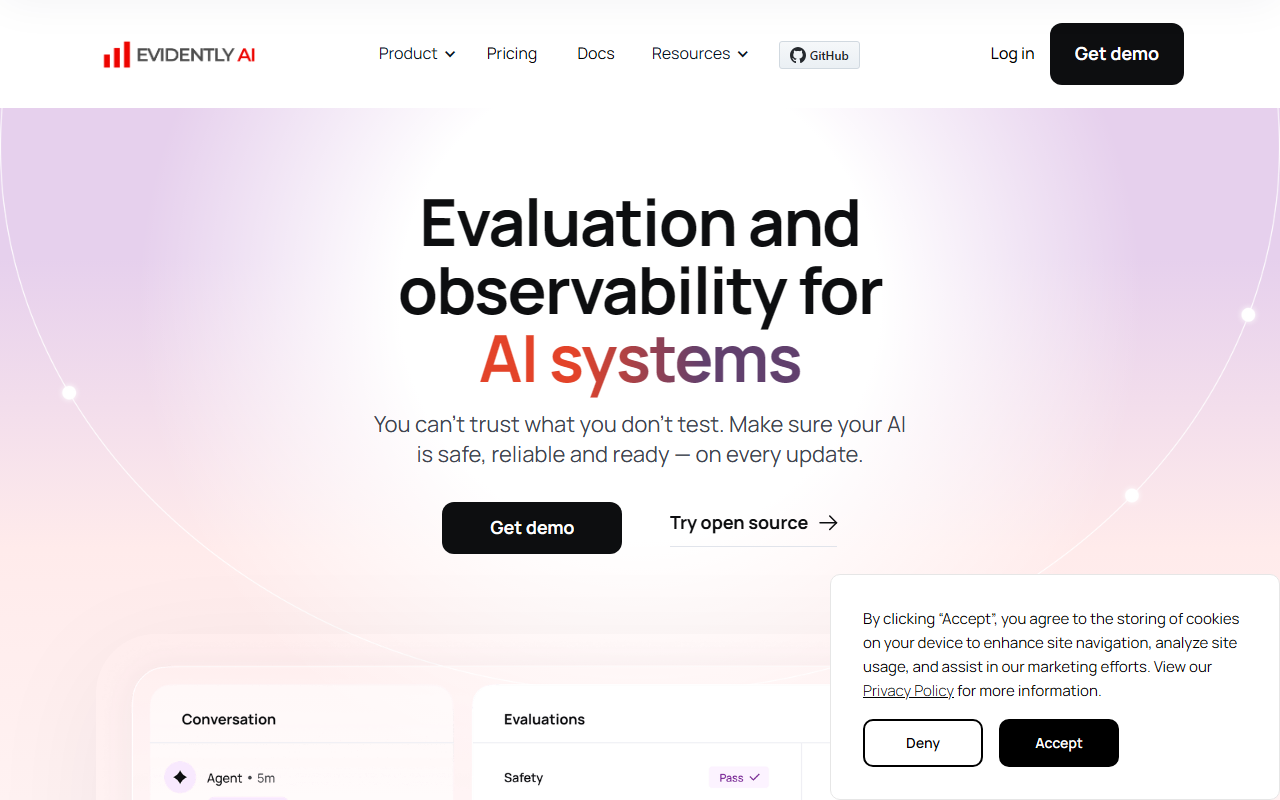
访问 Evidently AI 的网站时,我立刻被其价值主张的清晰性所吸引:“你无法信任未经测试的内容。” 着陆页毫不耽搁地直击非确定性 AI 故障的核心挑战——幻觉、边缘情况、PII 泄露、越狱以及级联错误。在注册演示后可进入的仪表盘,界面简洁,左侧导航栏链接至评估、仪表盘和合成数据生成工具。开源版本的入门过程十分直接:安装 Python 包后运行几行代码即可生成第一份评估报告。我通过从他们的 GitHub 仓库克隆一个示例 RAG 流水线进行了测试,几分钟内就获得了一份可视化报告,突出显示了检索准确性和幻觉分数。开源工具在本地运行,而平台版本则增加了协作功能、持续监控以及托管基础设施。
核心能力与技术
Evidently AI 围绕两个互补产品构建:一个开源 Python 库(拥有超过 7,000 个 GitHub Star 和 3,500 万次下载)和一个云平台。该库提供 100 多种预构建指标,用于评估 LLM 输出,包括准确性、安全性、相关性、毒性、PII 检测,以及使用任何提示或模型的自定义条件。平台在此基础上扩展,提供自动化评估流水线、用于对抗测试的合成数据生成,以及用于持续监控的实时仪表盘。最令我印象深刻的是 LLM-as-a-Judge 能力,它允许你利用 LLM 本身来评估输出——该平台在一份免费指南中详细记录了这项技术。对于 RAG 评估,你可以测试上下文相关性、忠实度和检索精度。对于 AI Agent,该工具可以验证多步推理和工具使用。该平台还支持通过 Python 进行自定义评估,使其对非标准用例具有灵活性。
市场定位与局限性
Evidently 在开源灵活性和企业级可观测性之间占据了一个独特的位置。与 LangSmith(更侧重追踪)和 Arize AI(在生产监控方面更强)等竞品相比,Evidently 强调部署前的验证,同时仍提供生产漂移检测。一个突出的优势是其活跃的社区(超过 3,000 名成员)以及 DeepL 和 Wise 等知名用户的背书。然而,也存在一些局限性。该平台的定价未在网站上公开列出;必须申请演示才能获取报价——这对小团队来说是一个常见但有时令人沮丧的障碍。此外,功能强大的开源库需要 Python 专业知识,这对于希望拥有无代码评估仪表盘的非工程师利益相关者来说可能成为一道门槛。平台版本解决了这个问题,但同时引入了对其云基础设施的依赖。
最终评价
对于需要严格且可定制的 AI 评估的 ML 工程师和数据科学家来说,Evidently AI 是一个出色的选择。它特别适合那些从事 RAG、Agent 或对抗测试的团队,这些团队重视开源透明性并希望避免供应商锁定。如果你需要一个快速、一体化、价格透明的生产监控 SaaS 解决方案,你可能会更倾向于 Arize 或 WhyLabs。但对于深度测试和验证——尤其是如果希望精确看到你的 AI 是如何出错的——Evidently 开源库与可选平台的组合很难被超越。我建议从开源版本开始,当需要团队协作和持续监控时再扩展到平台版本。请访问 Evidently AI 官网(https://evidentlyai.com/)亲自探索。










评论