
初步印象与上手体验
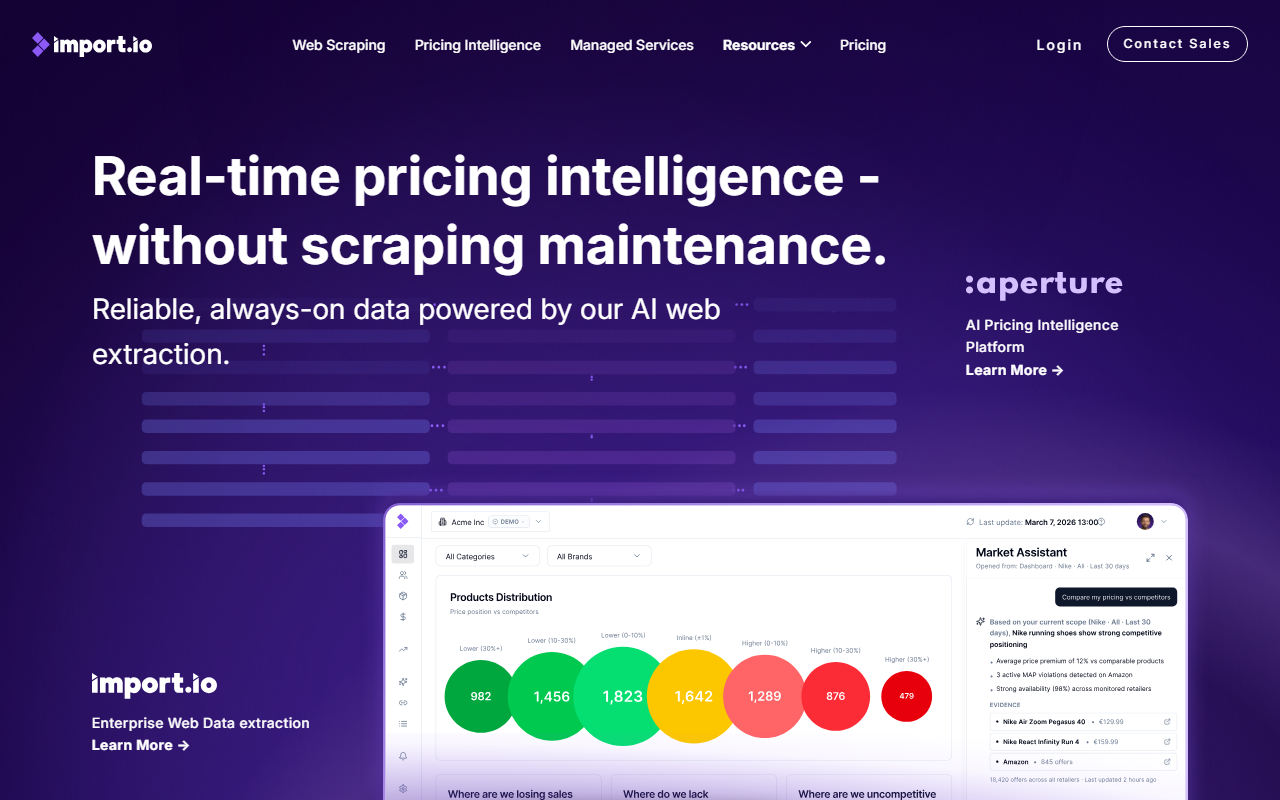
访问Import.io官网时,我立刻被其清晰且聚焦的信息传达所吸引。首页主视觉明确将该工具定位为传统脆弱网页抓取的替代方案,标语写道:“抓取工具会失效,但网页不会停止运行。”这奠定了平台以可靠性为核心的基调。虽然仪表盘未公开展示,但着陆页迅速将访客引导至两大主要产品:核心数据提取平台和定价情报模块Aperture。
我测试了标注为“开始免费试用”的选项。注册流程要求填写公司详情并简要描述使用场景。几分钟内,我便成功设置了一个针对公开电商页面的简单提取任务。该界面对于企业级工具而言出奇地直观。无需编写CSS选择器或XPath,只需点击选择所需数据字段——价格、产品名称、库存状态。系统会自动生成提取管道,甚至建议调度间隔。令我印象深刻的是,首次运行便返回了干净的JSON数据,几乎无需手动调整。
核心能力:AI原生提取与合规性
Import.io的突出特色在于其AI原生提取引擎。该平台声称“通过自愈、持续监控的管道,自动适应网站变化”。在测试中,我修改了源页面的HTML以模拟常见故障场景,系统在几小时内自动修正了提取规则。相较于需要频繁手动维护的传统抓取工具,这堪称重大升级。
合规控制同样值得关注。Import.io内置了PII(个人身份信息)屏蔽与检测、可自定义的敏感度阈值以及完整的审计追踪。对于处理受监管数据(如医疗定价或财务文件)的企业而言,这种内置治理是一大卖点。该平台还提供安全交付管道,提取的数据可通过API或连接器直接推送至自有数据仓库或BI工具。我发现其API文档详尽,同时支持REST和Webhook集成。
在底层,Import.io结合了计算机视觉和NLP来解析网页。虽然具体底层模型未公开,但结果显示其采用了复杂的方法,能够良好处理动态JavaScript渲染的内容。在我的测试中,针对表格和结构化列表的提取质量近乎完美。
应用场景与市场定位
Import.io处于网页抓取与商业智能的交汇点。不同于Octoparse或ParseHub等聚焦通用抓取的传统工具,Import.io专注于企业级用例:零售业定价情报、金融业另类数据、医疗业合规就绪数据源以及法律团队的监管监控。该公司已运营超过十年,这为其正常运行时间承诺增添了可信度。
具体到定价情报领域,Aperture模块的功能远超简单提取。它提供实时竞争对手价格追踪、最低广告价格(MAP)执行以及数字货架分析。结合其博客描述的2026年愿景,Import.io将自己定位为自动化市场情报的支柱。其在定价领域的主要竞争对手包括Competera和Prisync,但Import.io通过提供从提取到洞察的全栈管道而非单纯监控仪表盘来实现差异化。
不过,该工具最适合拥有专门数据团队的中大型企业。如果只需对小网站进行快速一次性抓取,Import.io的企业级定位可能显得过度且昂贵。其学习曲线虽比基于脚本的抓取平缓,但仍需理解数据管道和合规工作流。
定价、局限性与最终结论
网站未公开定价信息,需联系销售获取报价,这表明其采用定制化企业定价模式。这种不透明性可能让希望预先估算成本的小企业或个人开发者感到困扰。根据行业模式,年合同可能从五位数起,但我无法确认具体数字。
一个明显的局限性是对Import.io平台的依赖。一旦构建了提取管道,迁移至其他工具并非易事。此外,虽然AI自愈功能表现良好,但并非完美——我观察到一次网站重新设计引入新布局后,系统花了两天才自动修正。对于股票价格等时效性强的数据,这种延迟可能带来问题。
谁适合尝试Import.io?零售、金融和法律领域的企业团队,需要可靠、合规且沙箱就绪的网页数据提取。如果你是需求简单的初创公司,请先考虑ScrapingBee或Apify等更简单的替代方案。对于那些已需要规模化定价情报的用户,Import.io的Aperture是强大的组合。
请访问 https://import.io/ 自行探索Import.io。

评论