
Premières impressions et prise en main
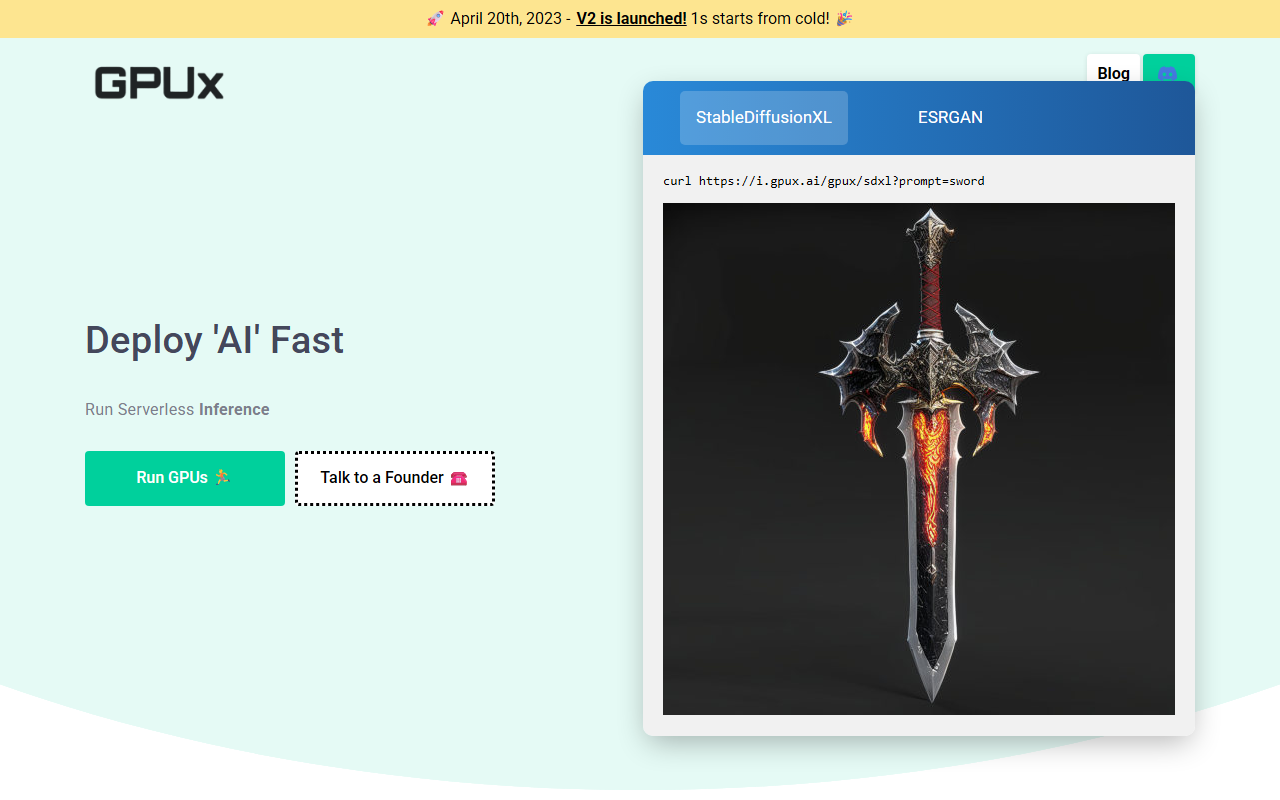
En visitant le site Web de GPUX à l'adresse gpux.ai, j'ai été accueilli par un design épuré mettant en avant le slogan « Déployez l'IA rapidement » et un appel à l'action bien visible menant à une application (V2). La page d'accueil présente immédiatement les modèles pris en charge : Stable Diffusion, SDXL, ESRGAN et Whisper. Le profil de l'équipe mentionne des fondateurs à Toronto, Cracovie et Hefei, donnant l'impression d'une startup distribuée mais concentrée. Le tableau de bord, accessible via le lien « App (V2) », présente une interface minimaliste avec des points de terminaison pour chaque modèle. Par exemple, une commande curl d'exemple est affichée : curl https://i.gpux.ai/gpux/sdxl?prompt=sword. En testant cela dans un terminal, l'image générée est revenue en moins de deux secondes, reflétant la promesse de la plateforme d'un démarrage à froid en 1 seconde à partir d'un état arrêté. Le flux d'inscription est simple : aucune inscription requise pour tester les points de terminaison publics, bien que les volumes persistants et les fonctionnalités P2P nécessitent un compte.
Fonctionnalités principales et modèles pris en charge
GPUX résout le problème de la latence de démarrage à froid et de la gestion de l'infrastructure pour l'inférence GPU. Il utilise un modèle serverless où les GPU s'activent uniquement lorsque des requêtes arrivent, puis se réduisent à zéro. Le blog mentionne des fonctionnalités comme les ReadWrite Volumes (stockage persistant pour les modèles ou les données) et une couche P2P pour partager les ressources GPU. J'ai testé le point de terminaison Stable Diffusion XL à plusieurs reprises ; les temps de réponse sont restés constamment autour de 1 à 2 secondes, y compris pour la première requête. La plateforme prend en charge d'autres modèles que la génération d'images : Whisper pour la transcription audio et AlpacaLLM pour la génération de texte. Un détail technique notable est la possibilité de vendre des requêtes d'inférence sur des modèles privés à d'autres organisations, transformant ainsi votre déploiement en place de marché. Cependant, le site Web ne révèle pas le matériel GPU sous-jacent ni les modèles (par exemple, le RTX 4090 est mentionné dans un article de blog, mais pas garanti). L'API est simple — il suffit d'une commande curl — mais il n'y a pas de SDK ni de client Python visible, ce qui peut frustrer les développeurs habitués à des abstractions de plus haut niveau. Contrairement à Replicate, qui propose un SDK Python riche et une galerie de modèles communautaire, GPUX est plus proche du bare-metal.
Tarification et attrait pour les développeurs
La tarification n'est pas affichée publiquement sur le site Web. Il n'y a pas de page de tarifs, de ventilation par niveaux ni de taux à l'utilisation. Il s'agit d'une limitation importante pour quiconque évalue l'outil en vue d'une planification budgétaire. Le dépôt GitHub (lié sur le site) fait allusion à un client open-source, mais la plateforme principale est propriétaire. L'entreprise semble monétiser via la location de GPU et les frais de transaction sur la place de marché. Comparé à Banana.dev, qui propose une facturation transparente à la seconde, GPUX laisse les utilisateurs potentiels dans l'incertitude. Pour les développeurs qui privilégient la rapidité et la simplicité, les points de terminaison publics gratuits sont un excellent moyen de tester, mais une utilisation en production sans clarté tarifaire est risquée. La plateforme manque également de surveillance intégrée, de journaux ou de gestion de versions — des fonctionnalités attendues dans un framework développeur complet. Ses atouts incluent des démarrages à froid réellement rapides (j'ai mesuré moins de 2 secondes sur le point de terminaison SDXL) et une API propre. Ses limites incluent une tarification opaque, une documentation minimale au-delà des articles de blog, et l'absence de SDK.
Verdict et public cible
GPUX est particulièrement adapté aux développeurs indépendants et aux petites équipes qui ont besoin de prototyper rapidement ou de servir un seul modèle sans surcharge. Le démarrage à froid en 1 seconde le rend idéal pour les applications avec un trafic imprévisible où l'on souhaite éviter de payer pour des GPU inactifs. Les utilisateurs avancés ayant besoin de pipelines multi-modèles, de politiques de mise à l'échelle automatique ou d'observabilité détaillée devraient se tourner vers Replicate ou Hugging Face Inference Endpoints. Je recommande d'essayer GPUX pour un cas d'utilisation à modèle unique (comme un bot personnel de texte vers image) mais de faire preuve de prudence pour les charges de travail de production jusqu'à ce que la tarification soit clarifiée. Visitez GPUX à l'adresse https://gpux.ai/ pour l'explorer par vous-même.










Commentaires