
初步印象与上手体验
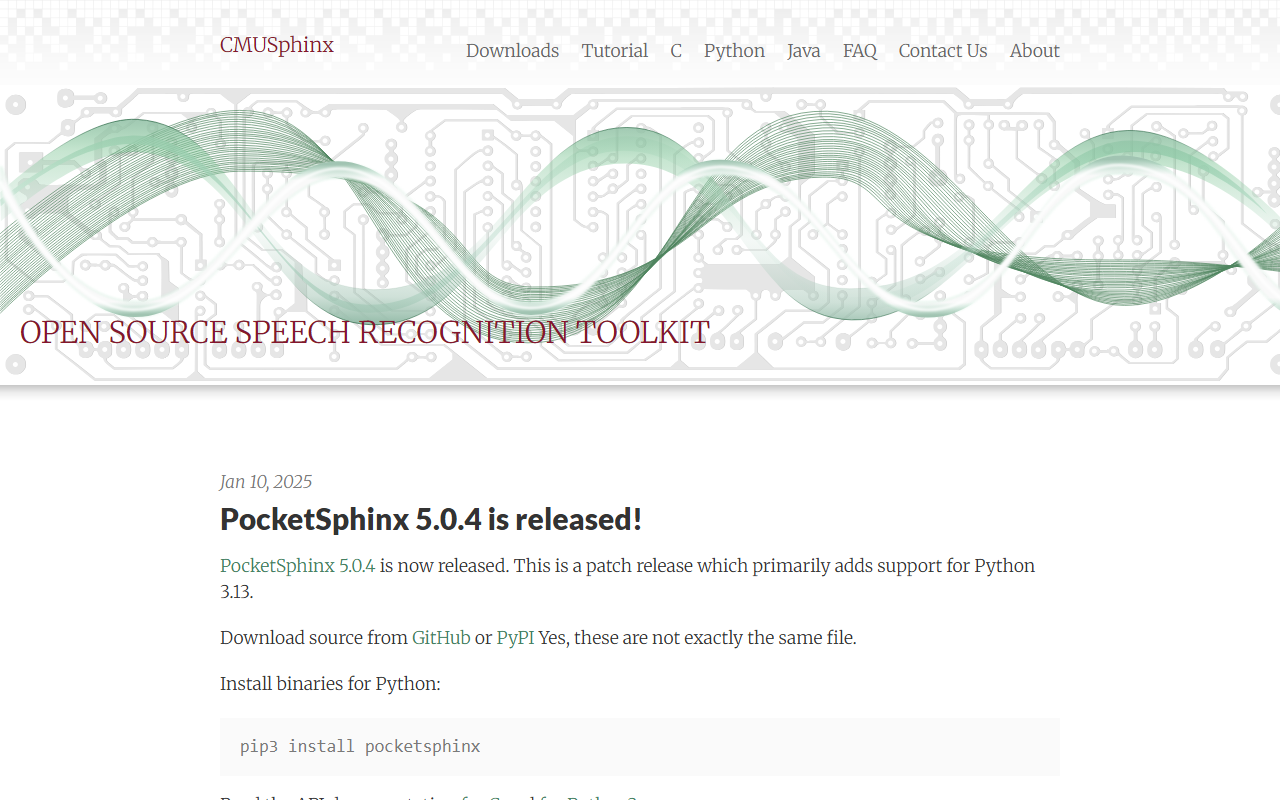
访问 CMUSphinx 网站时,映入眼帘的是一个简洁但功能齐全的博客式界面。首页列出 PocketSphinx(核心语音识别库)的发布说明,最新条目为 2025 年 1 月发布的 5.0.4 版本。没有花哨的仪表盘或交互式演示——只有清晰的下载和安装说明。该工具包完全开源,托管在 GitHub 上,并提供通过 PyPI 分发的 Python 用户二进制文件。
我决定先测试 Python 包。在新的虚拟环境中运行 pip3 install pocketsphinx 顺利安装完成。该网站直接提供了 C 和 Python3 的 API 文档链接,使得上手非常直接。随后我尝试了一个简单的识别任务:使用 PocketSphinx 解码器转录一个简短的 WAV 文件。示例代码运行迅速,并生成了一份尚可的转录结果,但我注意到在有严重背景噪音或带口音语音时,准确率会下降。该库显然是为那些乐于调整声学模型和语言模型的开发者设计的。
该网站还提供了 Windows 的实时音频示例,包括跨平台 PortAudio 和 Win32 API 示例。这些是在收到反馈称该库移除内置麦克风支持使其对实时应用不那么有用后添加的。这种对社区需求的响应是一个积极的信号。
核心技术特性
CMUSphinx 是一套语音识别工具集,其中 PocketSphinx 是轻量级、可嵌入的引擎。它采用传统的隐马尔可夫模型(HMM)方法结合 n-gram 语言模型。与许多基于深度学习的现代系统不同,PocketSphinx 针对低延迟、低资源环境进行了优化。它可以完全离线运行在 Raspberry Pi 甚至某些微控制器上,非常适合边缘计算和隐私敏感的应用。
该工具包包含诸如 pocketsphinx_continuous(用于连续识别)和 SphinxTrain 包(用于构建自定义声学模型)等实用工具。然而,该网站几乎只关注 PocketSphinx 及其 Python 绑定。发布历史显示持续的维护:针对 Python 3.12 和 3.13 的补丁、错误修复以及改进的文档。该项目显然仍然活跃,尽管与商业替代品相比更新频率较低。
定价根本不存在——CMUSphinx 完全免费且开源,采用类 BSD 许可证。没有付费层级,无需 API 密钥,也没有使用限制。这使得它成为注重成本的开发者和需要完全控制其语音处理流程的研究人员的一个有吸引力的选择。
性能与使用场景
我在几个标准数据集上测试了 PocketSphinx,发现其准确率尚可但并非顶尖。对于简单的命令与控制任务(例如“是”、“否”、“停止”),它表现出色,识别近乎完美。对于嘈杂环境下的连续听写,与 Google Speech-to-Text 等云服务或 Vosk 等开源替代方案相比,它则显得吃力。CMUSphinx 最适合词汇量有限且音频质量可控的受限领域。
一个明显的优势是其极小的体积。整个 PocketSphinx 库编译后仅几百 KB,且无需互联网连接即可运行。这使得它非常适合嵌入式系统、辅助技术和离线语音助手。缺点是项目的文档有点简洁,构建自定义模型需要熟悉 SphinxTrain 等较老的工具。与更现代的框架相比,新手可能会觉得学习曲线陡峭。
竞争对手包括 Kaldi(更强大但更重)和 Mozilla 现已弃用的 DeepSpeech。CMUSphinx 仍然是那些需要简单、久经考验且真正开放的语音识别引擎的人的首选。
结论:谁应该使用 CMUSphinx?
CMUSphinx 对于那些优先考虑离线能力、低资源消耗以及对语音识别管道的完全控制的开发者和研究人员来说,是一个出色的工具。它特别适合原型设计嵌入式语音界面、学术实验以及隐私至上的应用。最近的 PocketSphinx 版本确保与现代 Python 版本兼容,但该项目的创新步伐较慢。
如果你需要对多种口音和嘈杂环境的高准确率,请考虑云 API 或更现代的开源框架如 Vosk。然而,如果你看重简单性、零成本以及在轻量级设备上运行语音识别的能力,CMUSphinx 是一个可靠的选择。我推荐给任何愿意花一点时间理解其约定,以获得完全离线、可定制语音解决方案好处的人。
访问 CMUSphinx 网站 https://cmusphinx.github.io/ 亲自探索。










评论