
最初の印象とセットアップ
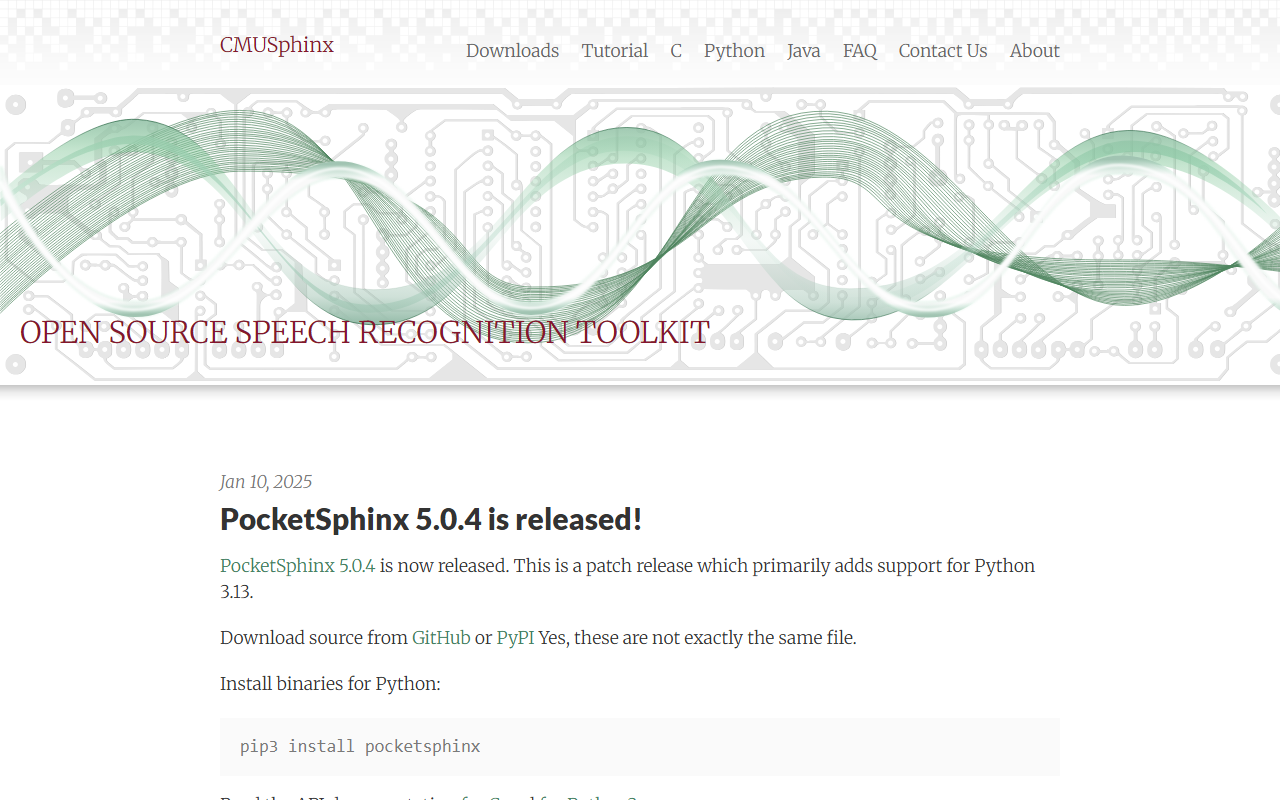
CMUSphinxのウェブサイトを訪れると、シンプルながらも機能的なブログ形式のインターフェースが表示されました。ホームページには、コアとなる音声認識ライブラリPocketSphinxのリリースノートが掲載されており、最新のエントリは2025年1月のバージョン5.0.4の発表です。派手なダッシュボードやインタラクティブなデモはなく、明確なダウンロード手順とインストール手順が記載されています。このツールキットは完全にオープンソースでGitHub上でホストされており、Pythonユーザー向けにはPyPI経由でバイナリが提供されています。
まずPythonパッケージをテストすることにしました。新しい仮想環境でpip3 install pocketsphinxを実行すると、問題なくインストールされました。C言語とPython3の両方のAPIドキュメントがサイトから直接リンクされており、すぐに使い始めることができました。次に、PocketSphinxデコーダーを使用して短いWAVファイルを文字起こしする簡単な認識タスクを試しました。サンプルコードは素早く実行され、妥当な文字起こし結果が得られましたが、背景ノイズが多い場合やアクセントのある音声では精度が低下することがわかりました。このライブラリは、音響モデルと言語モデルの調整に慣れている開発者向けに設計されていることは明らかです。
ウェブサイトには、Windows向けのライブオーディオ例も用意されており、クロスプラットフォームのPortAudioやWin32 APIの例が含まれています。これらは、ライブラリから組み込みマイクサポートが削除されたことでリアルタイムアプリケーションへの有用性が低下したというフィードバックを受けて追加されました。コミュニティのニーズに応えるこの姿勢は好印象です。
中核技術と機能
CMUSphinxは音声認識ツールのコレクションであり、PocketSphinxは軽量で組み込み可能なエンジンです。従来の隠れマルコフモデル(HMM)アプローチとn-gram言語モデルを組み合わせて使用しています。多くの最新の深層学習ベースのシステムとは異なり、PocketSphinxは低レイテンシー、低リソース環境向けに最適化されています。Raspberry Piや一部のマイクロコントローラ上でも完全にオフラインで動作するため、エッジコンピューティングやプライバシー重視のアプリケーションに最適です。
このツールキットには、連続認識用のpocketsphinx_continuousや、カスタム音響モデル構築用のSphinxTrainパッケージなどのユーティリティが含まれています。しかし、ウェブサイトはほぼ独占的にPocketSphinxとそのPythonバインディングに焦点を当てています。リリース履歴を見ると、Python 3.12および3.13向けのパッチ、バグ修正、ドキュメント改善など、継続的なメンテナンスが行われていることがわかります。商用の代替サービスと比較するとアップデート頻度は低いものの、プロジェクトは明らかにアクティブです。
価格は存在しません。CMUSphinxは完全に無料で、BSDライクなライセンスの下でオープンソースです。有料プランはなく、APIキーも不要で、使用制限もありません。そのため、コストを重視し、音声処理パイプラインを完全に制御する必要がある開発者や研究者にとって魅力的な選択肢です。
パフォーマンスとユースケース
いくつかの標準データセットでPocketSphinxをテストしたところ、精度はそれなりのものでしたが、最先端とは言えませんでした。単純なコマンド・アンド・コントロールタスク(例:「はい」「いいえ」「停止」)では、ほぼ完璧な認識性能を発揮しました。しかし、ノイズの多い環境での連続ディクテーションでは、Google Speech-to-TextやVoskなどのオープンソース代替サービスと比較すると苦戦しました。CMUSphinxは、語彙が限定され、音質が管理された制約されたドメインに最も適しています。
明確な強みの1つは、その最小限のフットプリントです。PocketSphinxライブラリ全体は数百キロバイトにコンパイルされ、インターネット接続なしで動作します。そのため、組み込みシステム、支援技術、オフライン音声アシスタントに最適です。欠点としては、プロジェクトのドキュメントがやや簡潔であり、カスタムモデルの構築にはSphinxTrainのような古いツールに精通している必要があります。初心者には、より現代的なフレームワークと比較して学習曲線が急だと感じられるかもしれません。
競合には、Kaldi(より強力だが重い)や、現在非推奨となっているMozillaのDeepSpeechが含まれます。CMUSphinxは、シンプルで実戦を経た、真にオープンな音声認識エンジンを必要とする人々にとって、今もなお第一の選択肢です。
総評:誰がCMUSphinxを使うべきか?
CMUSphinxは、オフライン機能、低リソース使用、音声認識パイプラインの完全な制御を優先する開発者や研究者にとって優れたツールです。組み込み音声インターフェースのプロトタイピング、学術実験、プライバシーが最優先されるアプリケーションに特に適しています。最近のPocketSphinxのリリースにより、現代のPythonバージョンとの互換性が確保されていますが、プロジェクトの革新のペースは遅いです。
多様なアクセントやノイズの多い環境で高い精度が必要な場合は、クラウドAPIやVoskのようなより現代的なオープンソースフレームワークを検討してください。しかし、シンプルさ、ゼロコスト、軽量デバイスでの音声認識実行能力を重視するなら、CMUSphinxは信頼できる選択肢です。完全にオフラインでカスタマイズ可能な音声ソリューションの利点を得るために、その規約を理解するのに少し時間を投資する意思がある方には、本製品をお勧めします。
CMUSphinxの詳細については、https://cmusphinx.github.io/ をご覧ください。










コメント