

第一印象与入门
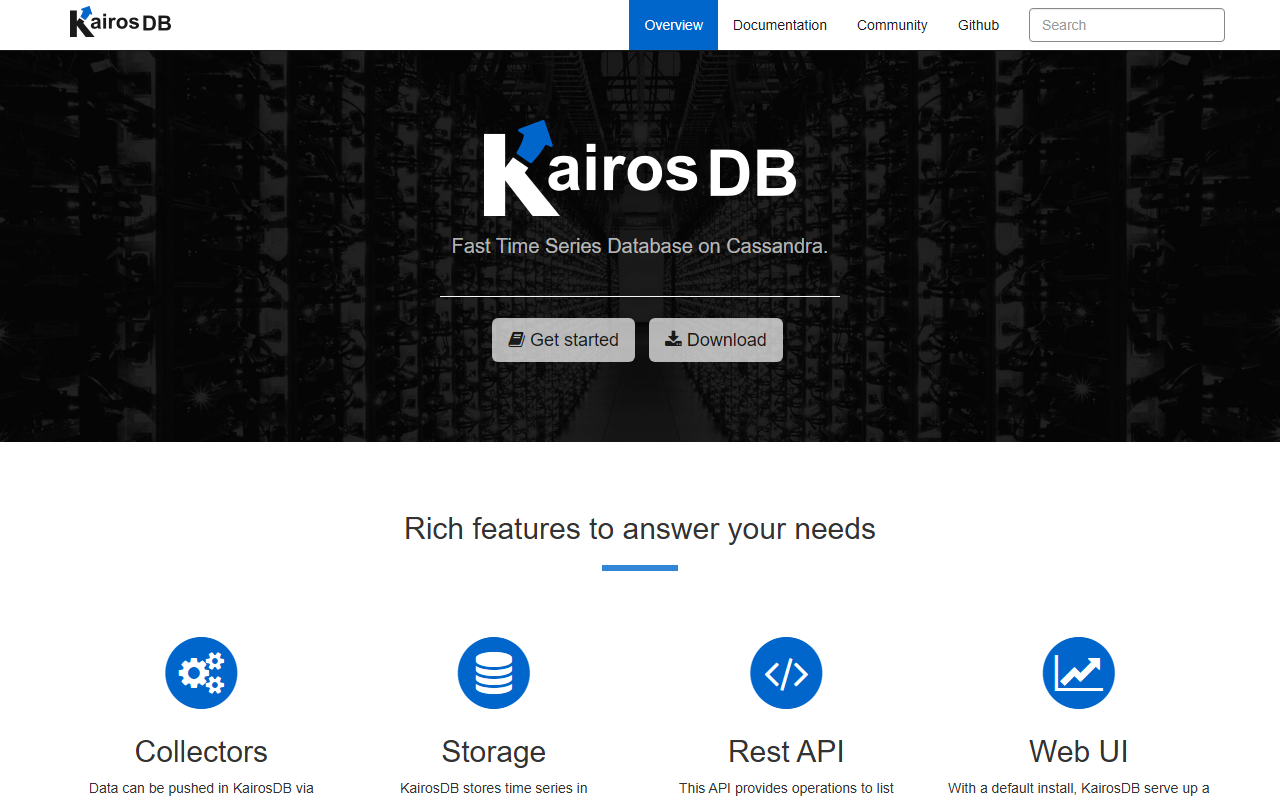
访问 KairosDB 网站 kairosdb.github.io 后,我立即注意到其过时的设计和 2015 年的版权年份。着陆页很直接:简短的标语“Fast Time Series Database on Cassandra”和一组功能卡片。我点击“开始”链接,进入基于 GitHub 的文档页面。入门过程包括从 GitHub 下载二进制文件、配置 Cassandra 实例并启动服务器。没有托管试用或 SaaS 层;必须自行设置。被描述为开发工具的 Web UI 很基础——一个用于浏览数据点的简单查询页面。我通过运行本地实例并使用 curl 通过 REST API 推送数据来测试免费层级。对于小数据集,响应时间可以接受,但缺少内置身份验证或现代查询语言(如 SQL 或 PromQL)立即显现出来。
功能与集成深度
KairosDB 的核心价值在于将时间序列数据存储在 Cassandra 的列族模型中,这提供了横向扩展和快速写入。其模式使用三个列族:数据点、度量名称和标签索引。REST API 列出度量名称、标签,并允许插入和查询数据点。我编写了一个 Python 脚本推送 10,000 个温度读数;REST 端点在毫秒内响应。聚合器包括 min、max、sum、count、mean 和下采样——对于总结长期趋势至关重要。客户端库仅支持 Java,但 REST API 使其可用于任何语言。基于 Guice 的插件允许自定义数据存储、协议处理器和数据点监听器。然而,与现代竞争对手如 InfluxDB(支持 Flux 和 SQL)或 TimescaleDB(基于 PostgreSQL,具有连续聚合)相比,KairosDB 的功能集显得有限。值得注意的是,没有内置的保留策略,下采样是手动的,并且其 GitHub 仓库的最后一次提交已超过六年。
使用场景与市场定位
KairosDB 最适合已投资 Cassandra 的团队,他们需要一个轻量级的时间序列层,而无需迁移到专门的数据库。它适用于中等数据量的 IoT 遥测、应用监控和 DevOps 指标。然而,寻求现代查询语言、自动保留或云原生部署的开发者应寻找其他选择。与 InfluxDB 不同,KairosDB 不支持 SQL 或 Flux,且其插件生态系统是静态的。该项目似乎处于维护模式,自 2015 年以来没有活跃的开发或社区更新。没有商业支持或大量用户群的迹象。对于生产环境,除非用例极其简单且静态,否则我不愿依赖一个未维护的工具。
优势、局限与最终评价
KairosDB 的优势在于与 Cassandra 的紧密集成——如果已有 Cassandra 集群,添加 KairosDB 需要的开销极低。REST API 清晰且文档完善,聚合器功能可靠。然而,该工具有显著局限:无身份验证、无内置数据压缩、无水平自动分片(Cassandra 处理了这一点,但 KairosDB 在之上并未增加太多价值),并且完全缺乏现代功能如告警、仪表板集成或 SQL 支持。Web UI 几乎仅用于调试。考虑到其年代久远和不活跃,我只推荐将 KairosDB 用于教育目的或无法迁移的遗留系统。对于新项目,请选择 InfluxDB 或 TimescaleDB。请访问 KairosDB 官网 https://kairosdb.github.io/ 自行探索。










评论