
Premières impressions et expérience d’intégration
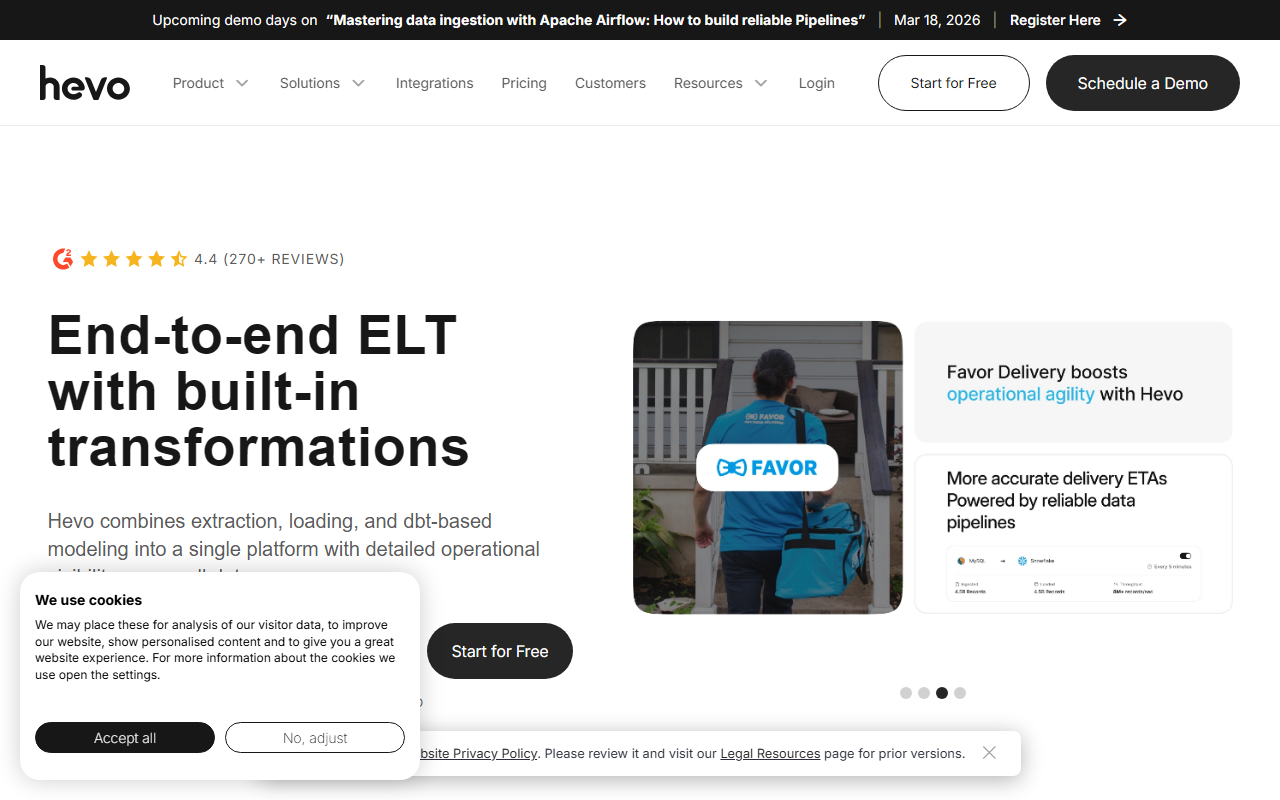
En visitant hevo.io, j’ai été accueilli par une page d’accueil propre et orientée entreprise qui met immédiatement en avant la promesse centrale de la plateforme : un ELT de bout en bout avec des transformations intégrées. L’appel à l’action pour un essai gratuit est bien visible, et aucune carte bancaire n’est requise — un début rafraîchissant pour les équipes soucieuses des coûts. J’ai parcouru la documentation produit et les vidéos de démonstration disponibles sur le site. Le processus d’intégration semble bien pensé : vous sélectionnez une source (parmi plus de 150 connecteurs préconstruits), choisissez une destination (comme Snowflake ou BigQuery) et configurez un pipeline en quelques clics. L’interface met l’accent sur la visibilité — l’état de chaque pipeline, ses logs et les alertes de dérive de schéma sont présentés dans un seul tableau de bord. J’ai particulièrement noté la fonctionnalité « Reliability Engine », qui gère automatiquement les échecs d’enregistrement et les changements de schéma sans intervention manuelle.
Fonctionnalités principales et profondeur technique
Hevo résout un problème critique pour les équipes data : déplacer et transformer les données à grande échelle sans charge opérationnelle. La plateforme combine l’extraction, le chargement et la modélisation basée sur dbt en un seul workflow. Cela élimine le besoin d’outils séparés pour la transformation — un avantage certain par rapport aux approches ETL traditionnelles. Sous le capot, Hevo utilise la Change Data Capture (CDC) pour une réplication de base de données quasi temps réel, garantissant que les bases de production ne sont pas impactées. Il gère également la réplication de fichiers à volume élevé depuis le stockage cloud, comme S3. La plateforme se met à l’échelle automatiquement — que vos données augmentent de 10x ou 100x, aucune modification d’infrastructure n’est nécessaire. Pour les développeurs, Hevo propose une API robuste, une intégration CI/CD et une orchestration avancée des pipelines. J’ai été impressionné par l’accent mis sur l’observabilité : les logs en temps réel et les insights granulaires au niveau système donnent aux ingénieurs un contrôle total. La plateforme prend également en charge plus de 2000 équipes data (comme indiqué sur le site) et traite plus de 1 Po par mois, soutenue par des témoignages clients de ThoughtSpot, Postman et Deliverr — tous faisant état d’économies de temps et de coûts significatives.
Tarification, positionnement et comparaison avec le marché
Hevo se commercialise avec une tarification transparente, mais les coûts exacts des niveaux ne sont pas listés publiquement sur le site web — vous devez demander une démo ou commencer un essai gratuit pour voir les chiffres précis. L’option « Start for Free » inclut probablement un niveau avec limite d’utilisation, idéal pour tester. Comparé à des concurrents comme Fivetran et Airbyte, Hevo se différencie en intégrant les transformations dbt directement dans le pipeline, réduisant ainsi la complexité de la chaîne d’outils. Fivetran propose également l’intégration dbt, mais l’approche tout-en-un de Hevo avec observabilité native et mise à l’échelle automatique constitue un argument de vente solide pour les entreprises de taille moyenne à grande. Stitch (de Talend) est une autre alternative, mais elle ne dispose pas du même niveau d’automatisation et de profondeur de transformation. Hevo est le mieux adapté aux ingénieurs data et aux architectes qui doivent gérer des centaines de connexions sources avec un minimum de code et une fiabilité maximale. Les équipes plus petites ou celles ayant des besoins très simples en données pourraient trouver l’ensemble des fonctionnalités de Hevo excessif — un outil léger comme la version open source d’Airbyte pourrait suffire.
Verdict final : forces, limites et recommandations
Les véritables forces de Hevo résident dans sa facilité d’installation, la gestion automatisée des schémas et une visibilité complète sur l’état des pipelines. L’intégration dbt est remarquable, facilitant la fourniture de données prêtes pour l’analyse et l’IA. Cependant, il y a des limites : l’absence de tarification publique rend l’évaluation initiale moins transparente, et l’accent important de la plateforme sur l’ELT peut ne pas plaire aux équipes qui préfèrent l’ingestion brute de données sans transformation. De plus, bien que la bibliothèque de connecteurs soit vaste (150+), certaines sources de niche peuvent nécessiter des constructions personnalisées — bien que Hevo propose de construire des connecteurs sur demande. Pour les équipes data cherchant à rationaliser leurs opérations ETL/ELT, en particulier celles qui utilisent déjà dbt, Hevo est un choix puissant. Je vous recommande de commencer par l’essai gratuit pour valider son adéquation avec votre volume et votre complexité de données. Visitez Hevo sur https://hevo.io/ pour l’explorer par vous-même.










Commentaires