
導入時の第一印象とオンボーディング体験
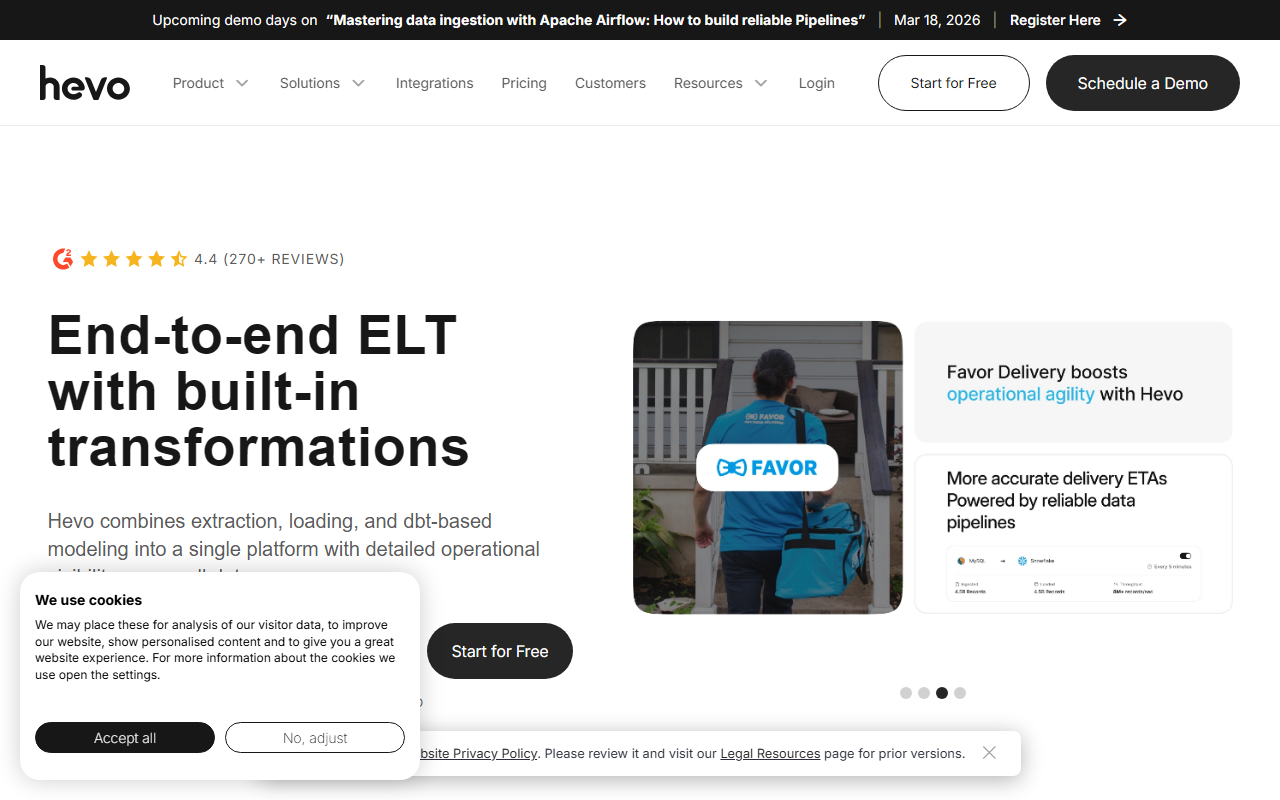
hevo.ioにアクセスすると、洗練されたエンタープライズ向けのランディングページが表示され、すぐにプラットフォームの中核的な約束である「変換機能を内蔵したエンドツーエンドのELT」が強調されます。無料トライアルへの呼びかけは目立つ位置にあり、クレジットカードは不要です。これはコストを重視するチームにとって嬉しいスタートです。私はサイト上の製品ドキュメントやデモ動画に目を通しました。オンボーディングの流れはよく考えられており、ソース(150以上のプリビルドコネクタから選択)を選び、宛先(SnowflakeやBigQueryなど)を指定し、数クリックでパイプラインを設定できます。インターフェースは可視性を重視しており、各パイプラインのステータス、ログ、スキーマドリフトのアラートが単一のダッシュボードに表示されます。特に注目したのは「Reliability Engine」機能で、手動操作なしでレコード障害やスキーマ変更を自動的に処理します。
コア機能と技術的な深み
Hevoはデータチームの重要な課題、つまり運用負荷をかけずに大規模なデータの移動と変換を実現します。このプラットフォームは、抽出、ロード、dbtベースのモデリングを1つのワークフローに統合します。これにより、変換用に別のツールが不要になり、従来のETLアプローチに比べて明確な利点があります。内部では、HevoはChange Data Capture(CDC)を使用してほぼリアルタイムのデータベースレプリケーションを実現し、本番データベースに影響を与えません。また、S3などのクラウドストレージからの大量ファイルレプリケーションも処理します。プラットフォームは自動的にスケールし、データが10倍や100倍に増えても、インフラの変更は不要です。開発者向けには、Hevoは堅牢なAPI、CI/CD統合、高度なパイプラインオーケストレーションを提供します。可観測性を重視している点に感銘を受けました。リアルタイムのログと詳細なシステムレベルのインサイトにより、エンジニアは完全な制御を掌握できます。このプラットフォームは2000以上のデータチーム(サイトで主張)をサポートし、月間1PB以上を処理しており、ThoughtSpot、Postman、Deliverrなどの顧客事例では、大幅な時間とコストの削減が報告されています。
料金、ポジショニング、市場比較
Hevoは透明性のある料金をうたっていますが、正確なティアのコストはウェブサイトに公開されていません。具体的な数字を確認するには、デモをリクエストするか無料トライアルを開始する必要があります。「無料で始める」オプションにはおそらく使用量制限付きのティアが含まれており、テストに最適です。競合のFivetranやAirbyteと比較すると、Hevoはdbt変換をパイプラインに直接組み込むことで差別化しており、ツールチェーンの複雑さを軽減します。Fivetranもdbt統合を提供していますが、Hevoのオールインワンアプローチは、ネイティブな可観測性と自動スケーリングを備えており、中規模から大規模のエンタープライズにとって強力なセールスポイントです。Stitch(Talend製)も代替手段ですが、同じレベルの自動化や変換の深さはありません。Hevoは、最小限のコーディングで最大の信頼性を求め、数百ものソース接続を管理する必要があるデータエンジニアやアーキテクトに最適です。小規模なチームやデータニーズが非常に単純な場合は、Hevoの機能セットは過剰かもしれません。その場合は、Airbyteのオープンソース版のような軽量ツールで十分でしょう。
最終評価:強み、制限、推奨事項
Hevoの真の強みは、セットアップの容易さ、自動スキーマ処理、パイプライン健全性の包括的な可視性にあります。dbt統合は際立った特徴で、分析やAIに対応したデータを簡単に提供できます。ただし、制限もあります。公開料金がないため初期評価の透明性が低く、プラットフォームがELTに大きく焦点を当てているため、変換なしで生のデータを取り込みたいチームには魅力的に映らないかもしれません。また、コネクタライブラリは豊富(150以上)ですが、一部のニッチなソースにはカスタムビルドが必要な場合があります。ただし、Hevoはリクエストに応じてコネクタを構築してくれます。ETL/ELT運用を合理化したいデータチーム、特にすでにdbtを使用しているチームにとって、Hevoは強力な選択肢です。まずは無料トライアルから始めて、データ量や複雑さに適合するか検証することをお勧めします。詳細はHevoのウェブサイト(https://hevo.io/)をご覧ください。










コメント