
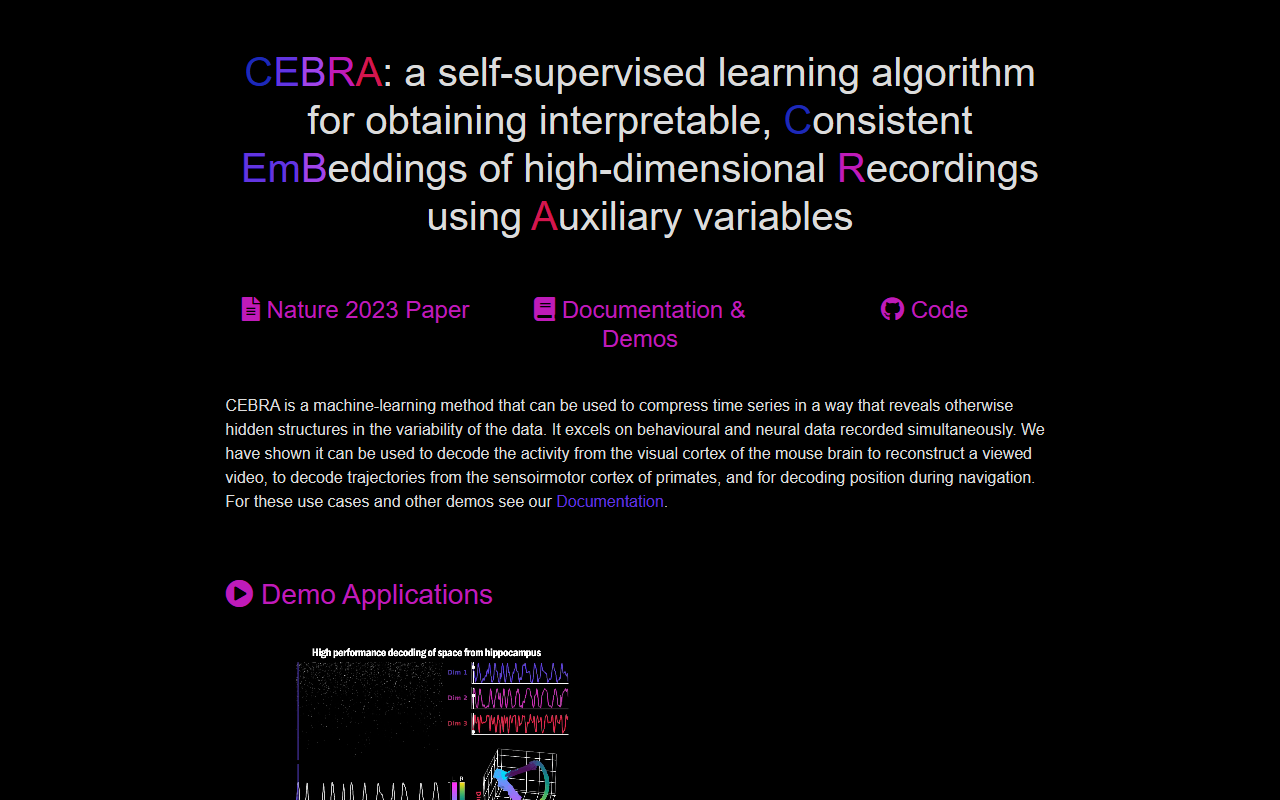
CEBRA란 무엇이며 어떤 문제를 해결하나요?
cebra.ai에 방문하면 일반적인 SaaS 인터페이스가 아니라 CEBRA를 소개하는 연구 프로젝트 페이지를 만나게 됩니다. CEBRA는 고차원 시계열 데이터, 특히 신경 및 행동 기록에서 해석 가능하고 일관된 임베딩을 생성하도록 설계된 자기 지도 학습 알고리즘입니다. 이 알고리즘이 해결하는 핵심 문제는 행동 변수와 함께 기록된 복잡한 다채널 신경 데이터(예: 칼슘 이미징, 전기생리학)에서 의미 있는 잠재 구조를 추출하는 어려움입니다. PCA나 t-SNE와 같은 전통적인 차원 축소 기법은 보조 정보를 무시하거나 시간적 일관성을 강제하지 못하는 경우가 많습니다. CEBRA는 지도 학습, 자기 지도 학습 또는 하이브리드 방식이 가능한 대조 학습 프레임워크에서 신경 활동과 행동 태그(예: 위치, 운동 방향)를 모두 활용하여 이러한 격차를 해소합니다.
웹사이트는 Nature 2023 게재 사실을 강조하며 코드, 문서 및 데모 노트북에 대한 링크를 제공합니다. CEBRA는 비전문가를 위한 플러그 앤 플레이 애플리케이션은 아니지만, 연구자들이 분석 파이프라인에 통합할 수 있는 강력한 오픈 소스 라이브러리(Python, PyTorch)입니다. 페이지에는 대화형 Colab 노트북과 비디오 예제가 포함되어 있으며, 여기서 CEBRA가 마우스 시각 피질 활동을 디코딩하여 비디오 프레임을 재구성하고, 쥐 해마 데이터를 디코딩하여 160cm 트랙에서 중앙값 오차가 5cm에 불과한 위치를 예측하는 모습을 보여줍니다. 이러한 데모는 실제 세계에서의 성능에 대한 생생한 인상을 주지만, 완전히 이해하려면 약간의 신경과학 배경 지식이 필요합니다.
기술 심층 분석: 모델, 데이터 및 성능
CEBRA는 'Consistent Embeddings of high-dimensional Recordings using Auxiliary variables'의 약자입니다. 이 알고리즘은 유사한 행동 상태에 해당하는 신경 활동 패턴을 끌어당기고 다른 패턴은 밀어내는 대조 손실 함수를 사용하며, 선택적으로 시간 조건을 적용할 수 있습니다. 이 알고리즘은 단일 또는 다중 세션 기록에 적용할 수 있으며, 종, 뇌 영역 및 기록 방식(칼슘 이미징, Neuropixels)에 걸쳐 작동합니다. 사이트에 따르면 CEBRA는 해석 가능할 뿐만 아니라 디코딩 작업(예: 마우스 시각 피질 활동에서 자연 영상 재구성)에서도 매우 뛰어난 성능을 보이는 잠재 공간을 생성합니다.
기술적인 관점에서 CEBRA는 PyTorch로 구현되었으며 오픈 소스 라이선스로 GitHub를 통해 배포됩니다. 저장소에는 포괄적인 문서, 튜토리얼 및 Jupyter 노트북이 포함되어 있습니다. 이 모델은 고차원 입력을 저차원 임베딩으로 매핑하는 신경망 인코더(구성 가능한 아키텍처)를 사용합니다. 시간적 근접성만 보조 변수로 사용하는 경우 훈련은 자기 지도 학습 방식이며, 명시적인 행동 레이블을 사용하는 경우 지도 학습 방식입니다. Nature 논문은 칼슘 이미징 및 전기생리학 데이터 세트 모두에서, 감각 및 운동 과제 전반에 걸쳐, 그리고 생쥐, 쥐, 영장류를 포함한 다양한 종에서 정확도를 검증합니다. 주목할 점은 사이트에서 비학술적 용도를 위한 EPFL의 특허 출원 중임을 언급하며, 이는 라이선스 없이 상업적 사용을 제한할 수 있다는 점입니다.
가격은 웹사이트에 공개적으로 명시되어 있지 않으며, CEBRA는 학술 연구용으로 무료입니다. 비학술적 용도로는 EPFL의 기술 이전 사무소에 문의하는 것이 좋습니다. 이러한 개방성은 장점이지만, 기업 지원이나 클라우드 API를 사용할 수 없다는 의미이기도 합니다. UMAP이나 jPCA와 같은 대안과 비교할 때 CEBRA는 보조 행동 변수를 활용하여 일관성을 강제함으로써 기본 신경 역학에 더 잘 정렬된 임베딩을 생성하는 독특한 장점을 제공합니다.
장점, 한계 및 사용 대상
CEBRA의 가장 큰 장점은 다른 방법이 놓치는 신경 데이터의 숨겨진 구조를 밝혀내면서 일관성에 대한 명확한 지표를 제공한다는 점입니다. 쥐 해마 디코딩 및 마우스 시각 피질 재구성 데모는 그 유용성을 입증하는 강력한 증거입니다. 또한 Nature에 게재되고 신경과학, 머신러닝, 뇌-컴퓨터 인터페이스 문헌에서 광범위하게 인용되면서 강력한 학문적 신뢰성을 얻고 있습니다. 코드베이스는 문서화가 잘 되어 있으며 EPFL의 Mathis 연구실에서 적극적으로 유지 관리하고 있습니다.
그러나 실제적인 한계도 있습니다. 첫째, CEBRA는 제품이 아니라 연구 도구입니다. 상당한 Python 숙련도와 신경 데이터 파이프라인에 대한 친숙함이 필요합니다. 그래픽 인터페이스나 노코드 옵션은 없습니다. 둘째, 알고리즘의 성능은 행동 레이블의 품질과 정렬에 크게 의존하므로 보조 변수 없이 순수하게 발견 중심의 작업에는 잘 작동하지 않을 수 있습니다. 셋째, 계산 리소스가 상당히 필요할 수 있습니다. 대규모 Neuropixels 데이터 세트를 훈련하려면 GPU 가속이 필요할 수 있습니다. 마지막으로, 특허 출원 중인 상태와 학술 라이선스 모델은 스타트업이나 상업용 BCI 응용 프로그램에 장벽이 될 수 있습니다.
이 도구는 신경 시계열 데이터를 다루며 행동 디코딩이나 잠재 신경 역학 발견이 필요한 신경과학 연구자, 계산 신경과학자, 데이터 과학자에게 가장 적합합니다. 도메인 특정 제약 없이 범용 시계열 임베딩 도구를 찾는 사람들은 UMAP이나 t-SNE가 더 접근하기 쉬울 수 있습니다. 신경-행동 결합 분석에 진지하게 관심이 있는 사람이라면 CEBRA는 반드시 탐구해야 할 리소스입니다. cebra.ai를 방문하여 직접 확인해 보세요.










댓글