
CEBRAとは何であり、どのような問題を解決するのでしょうか?
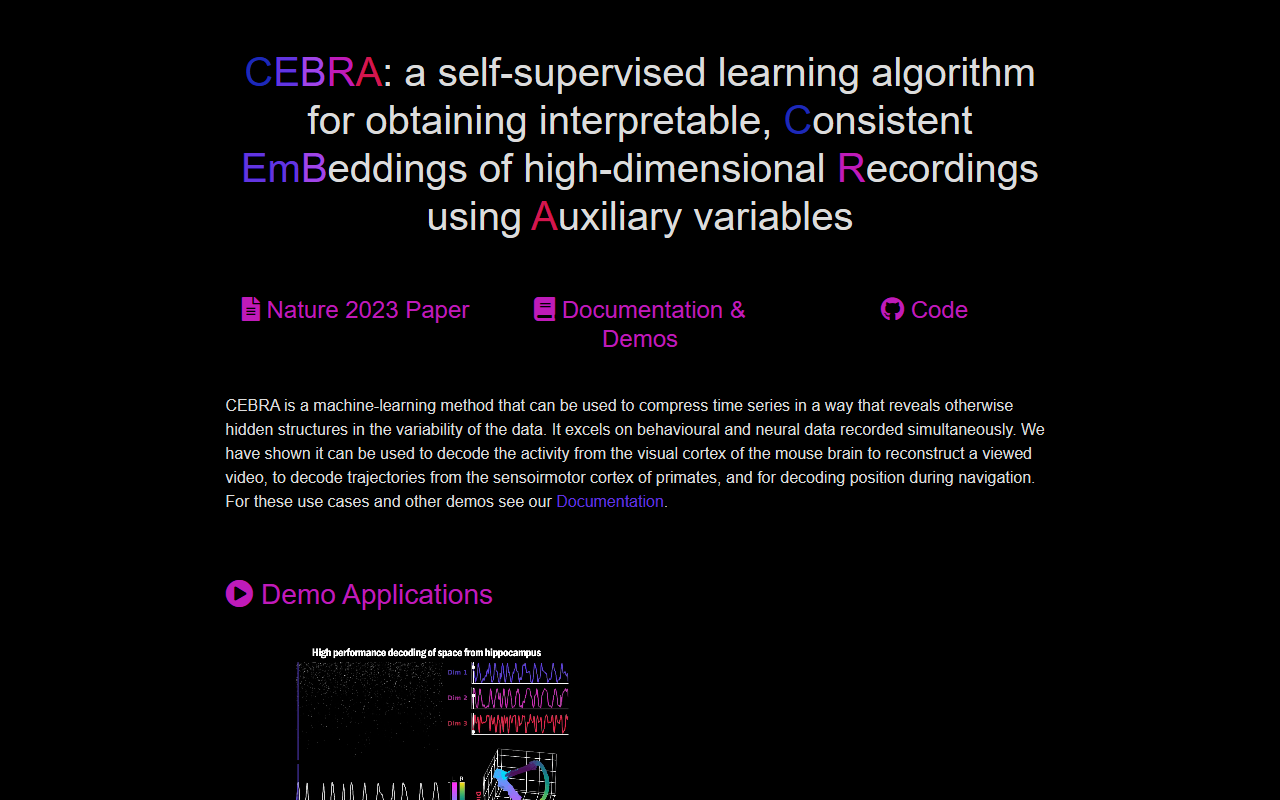
cebra.aiにアクセスすると、典型的なSaaSのインターフェースではなく、CEBRAを紹介する研究プロジェクトのページが表示されます。CEBRAは、高次元の時系列データ、特に神経活動や行動の記録から、解釈可能で一貫性のある埋め込みを生成するように設計された自己教師あり学習アルゴリズムです。このアルゴリズムが解決する中心的な問題は、複雑なマルチチャンネルの神経データ(例えばカルシウムイメージング、電気生理学)から、行動変数とともに記録された意味のある潜在構造を抽出する難しさです。従来の次元削減手法(PCAやt-SNEなど)は、補助情報を無視したり、時間的な一貫性を強制できないことがよくあります。CEBRAは、神経活動と行動タグ(例:位置、移動方向)の両方を活用した対照学習フレームワークにより、このギャップを埋めます。このフレームワークは、教師あり、自己教師あり、またはハイブリッドで使用できます。
ウェブサイトでは、Nature 2023への掲載が強調されており、コード、ドキュメント、デモノートブックへのリンクが提供されています。CEBRAは非専門家向けのプラグアンドプレイ型アプリではありませんが、研究者が自身の解析パイプラインに統合できる強力なオープンソースライブラリ(Python、PyTorch)です。ページにはインタラクティブなColabノートブックや動画の例が含まれており、CEBRAがマウスの視覚野活動をデコードしてビデオフレームを再構築したり、ラットの海馬データをデコードして160cmのトラック上で中央誤差わずか5cmで位置を予測する様子を示しています。これらのデモは、CEBRAの実際の能力を生き生きと伝えますが、完全に理解するにはある程度の神経科学の背景知識が必要です。
技術的な詳細:モデル、データ、パフォーマンス
CEBRAは、Consistent Embeddings of high-dimensional Recordings using Auxiliary variables(補助変数を用いた高次元記録の一貫性のある埋め込み)の略です。CEBRAは、類似した行動状態に対応する神経活動パターンを引き寄せ、異なるパターンを引き離す対照損失関数を使用します。必要に応じて時間条件を付加することもできます。このアルゴリズムは、単一セッションまたは複数セッションの記録に適用でき、種、脳領域、記録モダリティ(カルシウムイメージング、Neuropixels)を問わず機能します。サイトでは、CEBRAが解釈可能であるだけでなく、デコードタスク(例えばマウスの視覚野活動から自然動画を再構築するなど)において非常に高性能な潜在空間を生成すると報告されています。
技術的な観点から見ると、CEBRAはPyTorchで実装され、オープンソースライセンスの下でGitHubを介して配布されています。リポジトリには、包括的なドキュメント、チュートリアル、Jupyterノートブックが含まれています。モデルは、高次元の入力を低次元の埋め込みにマッピングするニューラルネットワークエンコーダ(構成可能なアーキテクチャ)を使用します。トレーニングは、補助変数として時間的近接性のみを使用する場合は自己教師あり学習となり、明示的な行動ラベルを使用する場合は教師あり学習となります。Nature論文では、カルシウムイメージングと電気生理学の両方のデータセット、感覚・運動タスク、そしてマウス、ラット、霊長類を含む種を横断して、その精度が検証されています。注目すべき点として、サイトではEPFLによる非学術利用向けの特許出願中である旨が記載されており、ライセンスなしでの商業利用が制限される可能性があります。
価格はウェブサイトに公開されていません。CEBRAは学術研究利用には無料だからです。非学術利用の場合は、EPFLの技術移転オフィスに連絡することが推奨されています。このオープン性は強みですが、エンタープライズサポートやクラウドAPIが利用できないことも意味します。UMAPやjPCAなどの代替手法と比較して、CEBRAは補助的な行動変数を活用して一貫性を強制できる独自の利点があり、その結果、基礎となる神経ダイナミクスにより適合した埋め込みが得られます。
強み、限界、そして誰が使用すべきでしょうか?
CEBRAの最大の強みは、他の手法では見逃される神経データ内の隠れた構造を明らかにし、同時に一貫性の明確な指標を提供できることです。ラットの海馬デコードとマウスの視覚野再構築のデモは、その有用性を示す説得力のある証拠です。さらに、Natureに掲載され、神経科学、機械学習、ブレイン・コンピュータ・インターフェースの文献で広く引用されていることから、高い学術的信用性があります。コードベースは十分に文書化されており、EPFLのMathis研究所によって積極的にメンテナンスされています。
ただし、現実的な制限もあります。第一に、CEBRAは研究ツールであり、製品ではありません。Pythonの熟練度と神経データパイプラインに関する知識がかなり必要です。グラフィカルインターフェースやノーコードオプションはありません。第二に、アルゴリズムのパフォーマンスは行動ラベルの品質と整合性に大きく依存します。補助変数がない純粋な発見駆動型タスクではうまく機能しない可能性があります。第三に、計算リソースが大量に必要となる場合があります。大規模なNeuropixelsデータセットでのトレーニングにはGPUアクセラレーションが必要になることがあります。最後に、特許出願中であることと学術ライセンスモデルは、スタートアップや商業用BCIアプリケーションにとって障壁となる可能性があります。
このツールは、行動のデコードや潜在的な神経ダイナミクスの発見を必要とする、神経時系列データを扱う神経科学研究者、計算論的神経科学者、データサイエンティストに最適です。ドメイン固有の制約がない汎用的な時系列埋め込みツールを探している方は、UMAPやt-SNEの方がより使いやすいと感じるかもしれません。神経と行動の統合解析に真剣に取り組む方にとって、CEBRAは必ず調査すべきリソースです。実際に試すには、cebra.aiにアクセスしてください。










コメント