
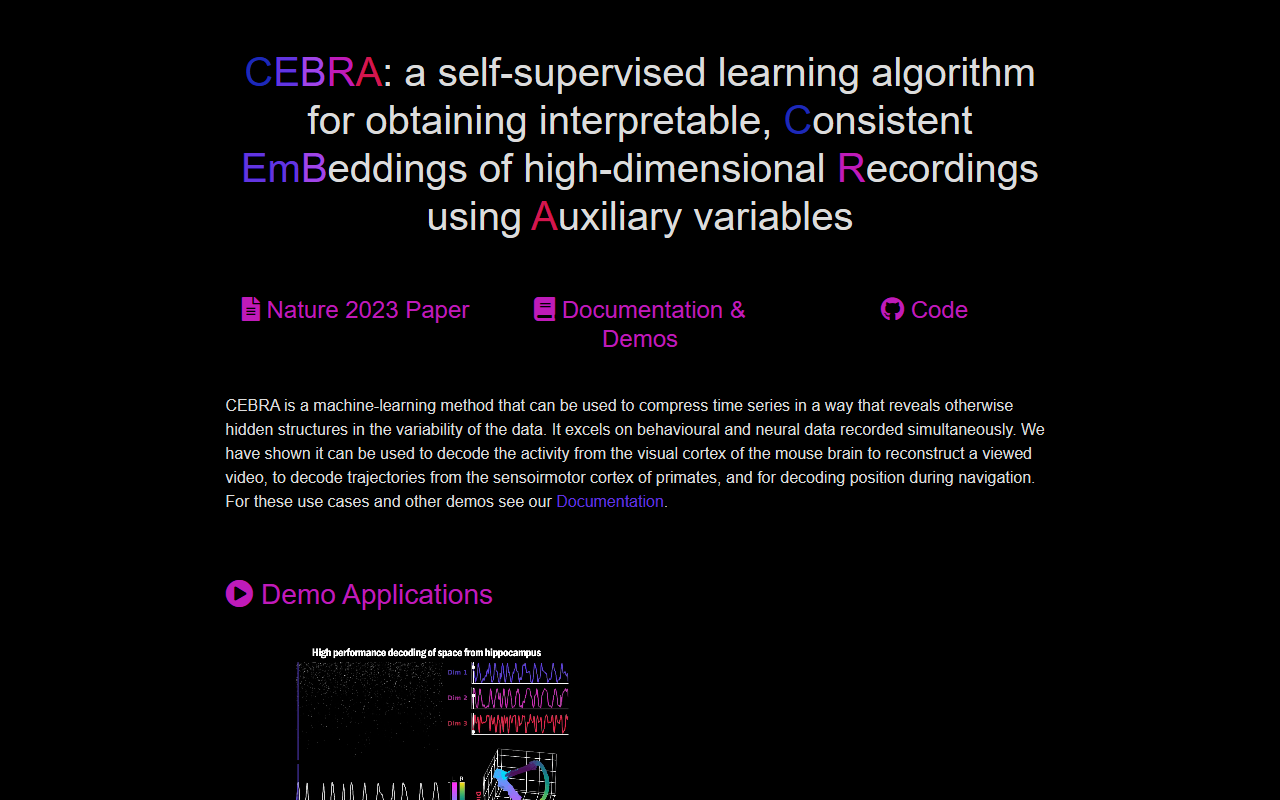
什么是 CEBRA?它解决了什么问题?
访问 cebra.ai 时,您看到的不是典型的 SaaS 界面,而是一个展示 CEBRA 的研究项目页面——这是一种自监督学习算法,旨在从高维时间序列数据(特别是神经和行为记录)中生成可解释且一致的嵌入。它解决的核心问题是从与行为变量同时记录的复杂多通道神经数据(例如钙成像、电生理学)中提取有意义的潜在结构。传统的降维技术如 PCA 或 t-SNE 常常忽略辅助信息,或者无法强制时间一致性。CEBRA 通过利用神经活动和行为标签(例如位置、运动方向)在一个可监督、自监督或混合的对比学习框架中架起了这一桥梁。
该网站重点介绍了其在《自然》2023年发表的论文,并提供了代码、文档和演示笔记本的链接。虽然 CEBRA 并非为非专家设计的即用型应用,但它是一个强大的开源库(Python, PyTorch),研究人员可以将其整合到自己的分析流程中。该页面包含交互式 Colab 笔记本和视频示例,展示了 CEBRA 解码小鼠视觉皮层活动以重建视频帧,以及解码大鼠海马体数据以预测位置,在160厘米轨道上的中位误差仅为5厘米。这些演示生动地展示了其实际能力,但需要一定的神经科学背景才能充分理解。
技术深度解析:模型、数据与性能
CEBRA 代表 Consistent Embeddings of high-dimensional Recordings using Auxiliary variables(使用辅助变量的高维记录的一致嵌入)。它使用对比损失函数,将对应相似行为状态的神经活动模式拉近,同时将不相似的模式推开,并可选择以时间为条件。该算法可应用于单次或多次记录,并适用于不同物种、脑区和记录模式(钙成像、Neuropixels)。网站报告称,CEBRA 生成的潜在空间不仅可解释,而且在解码任务(例如从小鼠视觉皮层活动重建自然电影)中表现出色。
从技术角度来看,CEBRA 使用 PyTorch 实现,并通过 GitHub 以开源许可证分发。该仓库包含全面的文档、教程和 Jupyter 笔记本。该模型使用一个神经网络编码器(可配置架构)将高维输入映射到低维嵌入。当仅使用时间邻近性作为辅助变量时,训练是自监督的;当使用明确的行为标签时,则是监督的。《自然》论文在钙成像和电生理数据集上,跨感觉和运动任务,以及跨小鼠、大鼠和灵长类等物种验证了其准确性。值得注意的是,该网站还提到了 EPFL 针对非学术用途的待批专利,这可能会限制未经许可的商业应用。
网站上未公开定价信息,因为 CEBRA 对学术研究免费使用。对于非学术用途,建议联系 EPFL 技术转让办公室。这种开放性是一个优势,但也意味着没有企业支持或云 API。与 UMAP 或 jPCA 等替代方法相比,CEBRA 提供了利用辅助行为变量来强制一致性的独特优势,从而生成更符合底层神经动力学的嵌入。
优势、局限性与适用人群
CEBRA 最大的优势在于其能够揭示其他方法遗漏的神经数据中的隐藏结构,同时提供一致性的清晰度量。大鼠海马体解码和小鼠视觉皮层重建的演示是其效用的有力证据。此外,它发表在《自然》期刊上,并在神经科学、机器学习和脑机接口文献中被广泛引用,赋予了其强大的学术可信度。其代码库文档齐全,并由 EPFL 的 Mathis 实验室积极维护。
然而,也存在实际限制。首先,CEBRA 是一个研究工具,而非产品。它需要较高的 Python 熟练度和神经数据流程的熟悉程度。没有图形界面或无代码选项。其次,该算法的性能在很大程度上取决于行为标签的质量和对齐——对于没有任何辅助变量的纯探索性任务,可能效果不佳。第三,计算资源需求较大:在大规模 Neuropixels 数据集上训练可能需要 GPU 加速。最后,待批专利和学术许可模式可能对初创公司或商业 BCI 应用构成障碍。
该工具最适合神经科学研究人员、计算神经科学家以及处理神经时间序列的数据科学家,他们需要解码行为或发现潜在神经动力学。那些寻求通用时间序列嵌入工具且无特定领域限制的人可能会发现 UMAP 或 t-SNE 更容易上手。对于任何认真对待神经行为联合分析的人来说,CEBRA 是一个必探索的资源。请访问 cebra.ai 自行探索。










评论