
First Impressions and Onboarding
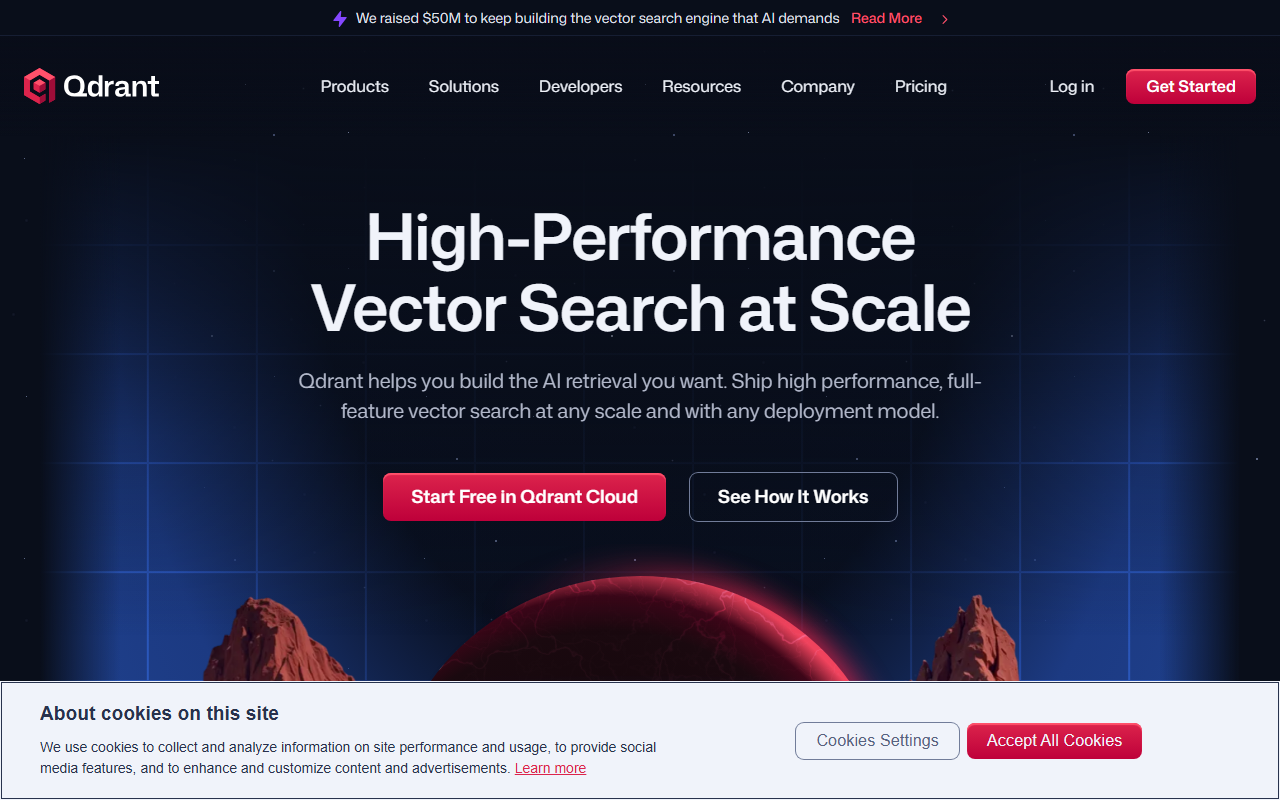
qdrant.tech를 방문했을 때 가장 먼저 인상적이었던 것은 깔끔하고 개발자 중심의 랜딩 페이지였습니다. 이 페이지는 성능 지표(25,000개 이상의 GitHub 스타, 60,000명 이상의 커뮤니티 회원 및 「대규모 고성능 벡터 검색」 태그라인)를 즉시 강조합니다. 네비게이션은 직관적이며 Products, Solutions, Developers, Resources 섹션으로 명확하게 구분되어 있습니다. Qdrant Cloud의 무료 등급 가입이 눈에 띄게 배치되어 있습니다. 계정을 만들고 짧은 온보딩 과정을 안내받아 몇 분 만에 소형 클러스터를 실행할 수 있었습니다. 대시보드에는 클러스터 메트릭, API 엔드포인트, 편리한 쿼리 플레이그라운드가 표시됩니다. 경험은 매우 원활했으며, 기술 사용자에게 불필요한 장애물이 없었습니다.
테스트 중에 제품 임베딩 샘플 데이터셋을 업로드하고 밀집(dense) 및 희소(sparse) 벡터 검색을 모두 실행했습니다. 복잡한 필터 조건에서도 응답 시간이 매우 짧았습니다. 기본 제공 하이브리드 검색(키워드와 벡터 결합)은 별도의 설정 없이도 잘 작동했습니다. 한 가지 작은 아쉬운 점은 문서가 상세하지만 다소 밀도가 높다는 점입니다. 초보자라면 HNSW 파라미터나 양자화 수준과 같은 개념을 이해하는 데 시간을 투자해야 할 수 있습니다. 그럼에도 불구하고 REST나 gRPC에 익숙한 사용자라면 API 설계가 직관적입니다.
Core Features and Technical Strengths
Qdrant는 Rust로 처음부터 구축되었으며, SIMD 최적화와 Gridstore라는 맞춤형 스토리지 엔진을 갖추고 있습니다. 이로 인해 많은 경쟁사보다 성능 면에서 큰 우위를 점합니다. 벡터 검색 엔진은 실시간 인덱싱을 지원하여 전체 인덱스를 다시 구축하지 않고도 새로운 벡터를 즉시 검색할 수 있습니다. 메모리 효율성도 또 다른 강점입니다. 고급 양자화 기술(스칼라, 바이너리, 비대칭)을 사용하면 높은 재현율을 유지하면서 메모리 사용량을 최대 64배까지 줄일 수 있습니다.
Qdrant를 차별화하는 요소는 광범위한 메타데이터 필터링입니다. 메타데이터를 JSON으로 저장하며 중첩 필드, 텍스트, 지리적 위치, 심지어 has_vector 조건에 대한 필터를 지원합니다. 필터링은 후처리 단계가 아니라 HNSW 그래프 탐색 중에 적용되므로 복잡한 쿼리에서도 낮은 지연 시간을 유지합니다. 기본 하이브리드 검색은 BM25, SPLADE++, miniCOIL을 지원하여 어휘 기반 검색과 의미 기반 검색을 원활하게 결합합니다. 또한 기본 제공되는 멀티벡터 지원(객체당 여러 벡터)은 멀티모달 사용 사례를 가능하게 합니다. 점수 부스팅, ColBERT와 같은 후기 상호작용 모델, 최대 한계 관련성(Maximum Marginal Relevance)을 포함한 전체 스펙트럼 재순위화는 추가적인 제어 수준을 제공합니다.
제 테스트에서 원스테이지 필터링이 특히 인상적이었습니다. 1,000만 개의 벡터에 대해 지리적 필터 검색을 실행했을 때 일관되게 50ms 미만의 응답 시간을 보였습니다. 하이브리드 검색 기능도 순수 벡터 검색이나 키워드 검색이 놓쳤던 관련성 높은 결과를 반환하며 좋은 성능을 보였습니다. 이 도구는 RAG, 추천 시스템, AI 에이전트와 같은 프로덕션 등급 AI 검색 시나리오에서 확실히 뛰어납니다.
Deployment Flexibility and Enterprise Readiness
Qdrant는 여러 배포 모델을 제공합니다. AWS, GCP 또는 Azure에서 완전 관리형 Qdrant Cloud, 제어 플레인과 데이터 플레인이 분리된 자체 Kubernetes 환경을 위한 Qdrant Hybrid Cloud, 폐쇄형 환경을 위한 Qdrant Private Cloud, 낮은 지연 시간의 온디바이스 검색을 위한 베타 버전 Qdrant Edge가 있습니다. 이 스펙트럼은 스타트업부터 대규모 엔터프라이즈까지 모든 것을 포괄합니다. 엔터프라이즈 기능도 탄탄합니다. SOC 2, HIPAA 규정 준수, SSO(SAML/OIDC), 세분화된 RBAC, 벡터 범위 API 키, 프라이빗 네트워킹, 무중단 업그레이드, 특정 시점 복원이 가능한 백업이 포함됩니다. Prometheus, Grafana, Datadog과 같은 모니터링 도구와의 통합도 가능합니다.
Pinecone, Weaviate, Milvus와 같은 대안과 비교할 때 Qdrant는 성능 우선의 Rust 아키텍처와 필터링 기능의 깊이에서 두드러집니다. Pinecone은 시작하기는 더 쉽지만 사용자 정의가 덜 가능합니다. Weaviate는 풍부한 스키마 기능을 제공하지만 더 무거울 수 있습니다. Milvus는 강력하지만 학습 곡선이 더 가파릅니다. Qdrant는 성능과 유연성이 모두 필요한 팀에 좋은 균형을 제공합니다.
한 가지 한계는 웹사이트에 가격이 공개되어 있지 않다는 점입니다. 가입하거나 영업팀에 문의해야 맞춤 가격을 확인할 수 있습니다. Qdrant Cloud의 무료 등급은 넉넉하지만 프로덕션으로 확장하려면 유료 플랜이 필요할 수 있습니다. 또한 타사 통합 생태계는 더 확립된 경쟁사에 비해 아직 성장 중입니다.
Qdrant는 누가 사용해야 할까요? Rust, Docker, 클라우드 네이티브 아키텍처에 익숙하고 고규모 벡터 검색 애플리케이션을 구축하는 엔지니어링 팀에 가장 적합합니다. 복잡한 메타데이터 필터링 요구 사항이 있는 기업(예: 전자상거래, 법률 기술, 헬스케어)이 큰 혜택을 볼 수 있습니다. 소규모 팀이나 DevOps 리소스가 제한된 팀은 초기에는 Pinecone과 같은 관리형 서비스를 선호할 수 있습니다.
전반적으로 Qdrant는 속도, 확장성, 유연성에 대한 약속을 이행하는 강력하고 잘 설계된 벡터 데이터베이스입니다. 프로덕션 AI 검색에 진지하게 접근하고 있다면 한번 사용해 보시기를 추천합니다.
직접 살펴보시려면 https://qdrant.tech/에서 Qdrant를 방문해 보시기 바랍니다.










댓글