
初步印象与上手体验
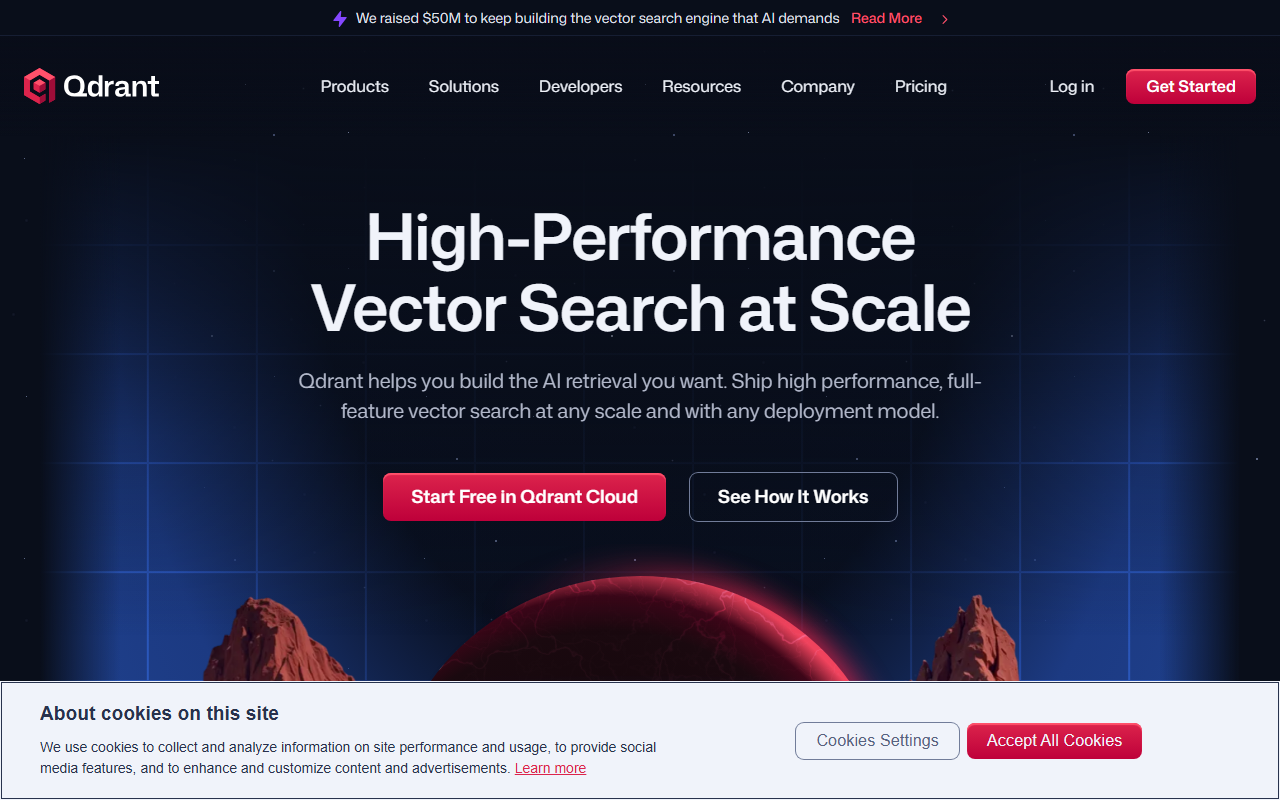
访问qdrant.tech时,我首先注意到的是简洁、以开发者为中心的登陆页面,页面突出展示了性能指标:25k+ GitHub星标、60k+社区成员,以及标语“大规模高性能向量搜索”。导航清晰明了,设有产品、解决方案、开发者和资源等明确板块。Qdrant Cloud免费版的注册入口十分醒目。我创建了一个账户,并通过快速上手流程在几分钟内启动了一个小型集群。仪表盘显示了集群指标、API端点以及一个便捷的查询游乐场。整体体验流畅——对技术用户来说毫无不必要的障碍。
测试期间,我上传了一个产品嵌入向量的示例数据集,并分别运行了稠密和稀疏向量搜索。即使面对复杂的过滤条件,响应时间也令人印象深刻地低。内置的混合搜索(结合关键词和向量)开箱即用,效果良好。一个小挫折:文档虽然详尽,但相当密集。初学者可能需要花时间理解HNSW参数或量化级别等概念。不过,API设计对于熟悉REST或gRPC的人来说非常直观。
核心功能与技术优势
Qdrant完全基于Rust构建,采用SIMD优化和名为Gridstore的自定义存储引擎。这使得它在性能上相比许多竞争对手具有显著优势。该向量搜索引擎支持实时索引——新向量无需重建整个索引即可立即被搜索。内存效率是另一个亮点:先进的量化技术(标量、二进制、非对称)可在保持高召回率的同时,将内存使用量降低多达64倍。
Qdrant的独特之处在于其广泛的元数据过滤能力。它以JSON格式存储元数据,并支持对嵌套字段、文本、地理甚至has_vector条件进行过滤。过滤是在HNSW图遍历期间应用,而非作为后处理步骤,即使面对复杂查询也能保持低延迟。原生混合搜索支持BM25、SPLADE++和miniCOIL,实现了词汇检索与语义检索的无缝融合。此外,内置的多向量支持(每个对象多个向量)开启了多模态用例。全谱重排序——包括分数提升、ColBERT等后期交互模型以及最大边际相关性——提供了另一层控制。
在我的测试中,单阶段过滤尤其令人印象深刻。我在1000万条向量上运行了地理过滤搜索,响应时间始终低于50毫秒。混合搜索功能也表现出色,返回了纯向量或关键词搜索遗漏的相关结果。这款工具显然在生产级AI检索场景(如RAG、推荐系统和AI代理)中表现出色。
部署灵活性与企业级准备
Qdrant提供多种部署模型:AWS、GCP或Azure上全托管的Qdrant Cloud;带自有Kubernetes、解耦控制平面和数据平面的Qdrant Hybrid Cloud;适用于气隙环境的Qdrant Private Cloud;以及用于低延迟设备端搜索的测试版Qdrant Edge。这个产品线覆盖了从初创公司到大型企业的所有需求。企业级功能很扎实:SOC 2、HIPAA合规性、SSO(SAML/OIDC)、细粒度RBAC、向量作用域API密钥、私有网络、零停机升级以及带时间点恢复的备份。还支持与Prometheus、Grafana和Datadog等监控工具的集成。
与Pinecone、Weaviate或Milvus等替代方案相比,Qdrant以其性能优先的Rust架构和深入的过滤能力脱颖而出。Pinecone入门更简单,但可定制性较差;Weaviate提供丰富的schema特性,但可能更重;Milvus功能强大但学习曲线更陡峭。Qdrant在性能和灵活性之间取得了很好的平衡,适合需要两者的团队。
一个限制是网站上未公开列出定价——需要注册或联系销售获取定制报价。Qdrant Cloud的免费版很慷慨,但扩展到生产环境可能需要付费计划。此外,与更成熟的对手相比,其第三方集成生态系统仍在发展中。
谁应该使用Qdrant?最适合构建大规模向量搜索应用、熟悉Rust、Docker和云原生架构的工程团队。对有复杂元数据过滤需求(如电商、法律科技、医疗保健)的公司来说收益巨大。较小的团队或DevOps资源有限的团队可能更适合先从Pinecone等托管服务开始。
总体而言,Qdrant是一款功能强大、设计精良的向量数据库,在速度、规模和灵活性方面兑现了承诺。如果你认真对待生产级AI检索,我建议试一试。
访问Qdrant官网 https://qdrant.tech/ 自行探索。










评论