
第一印象与入门指南
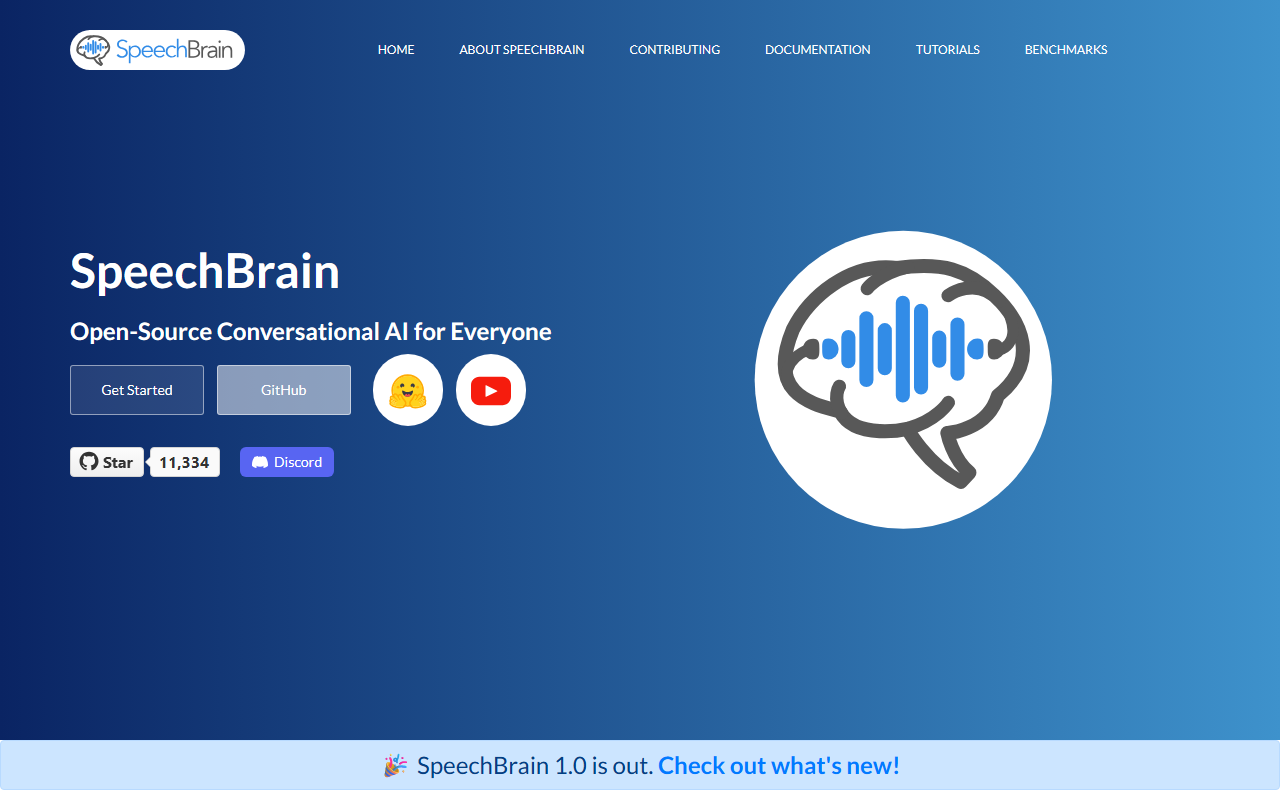
访问SpeechBrain网站时,其清晰的开发人员优先设计立即给我留下了深刻印象。首页突出显示1.0版本,这是一个标志着稳定性和成熟度的重大里程碑。作为开源框架,无需注册或付费;"开始使用"按钮直接跳转到安装说明。仪表盘(可以这么说)就是GitHub仓库和文档站点。我按照PyPI安装命令测试了免费层级——即整个项目。几分钟内,我就拥有了一个工作环境,可以访问数十个用于语音识别、说话人验证和文本转语音等任务的配方。基于YAML的配置是一大亮点:每个配方的超参数都存储在一个文件中,通过python train.py hparams/train.yaml即可触发训练。这种精简的工作流程使得重现结果或调整设置变得轻而易举,无需深入复杂的代码。
SpeechBrain的功能及背后的技术
SpeechBrain是一个全面的开源框架,用于构建对话式AI系统。它涵盖语音(识别、增强、分离、TTS、说话人识别、语音到语音翻译、SLU)、音频(声码化、增强、特征提取、声音事件检测、波束成形)以及文本(从n-gram到LLM的语言模型)。技术层面,它基于PyTorch,并支持自监督学习、持续学习、扩散模型和贝叶斯方法等先进深度学习技术。该工具包采用模块化设计:你可以通过继承sb.Brain来定义自定义模型、损失和循环。这种灵活性专为研究量身定制。HuggingFace集成提供了用于快速推理的预训练模型,但其真正优势在于用于在LibriSpeech、CommonVoice和VoxCeleb等数据集上进行基准测试的配方库。对于开发者来说,通过GitHub本地安装可让你完全访问所有配方,并能够自定义任何组件。
市场定位与替代方案
与Google Cloud Speech-to-Text或AWS Transcribe等商业服务不同,SpeechBrain完全免费且本地化,因此非常适合研究人员和注重隐私的团队。与其他开源框架相比,其广度独树一帜:ESPnet更专注于端到端语音处理,而Kaldi则较为陈旧且非PyTorch原生。Hugging Face的Transformers提供了语音模型,但缺乏SpeechBrain提供的集成训练配方和多任务流水线支持。SpeechBrain最适合学术实验室、研发团队以及需要从头训练自定义模型或对专有数据进行微调的高级开发者。对于更喜欢即插即用API的初学者来说,它可能会让人不知所措,尽管HuggingFace上的预训练模型接口有所帮助。该项目由社区驱动,合作者来自学术界和工业界,并通过活跃的Discord和GitHub频道提供支持。
优势、局限性与总结
最大的优势在于其整体方法:一个框架在统一流水线中处理语音、音频和文本。以可重复性为中心的设计——YAML配置加上清晰的训练脚本——对研究人员来说是一大福音。活跃的社区和频繁的更新(最近是v1.0)表明其维护良好。然而,学习曲线较陡。虽然文档尚可,但不熟悉PyTorch或语音处理的新手可能会遇到困难。此外,预训练模型生态系统比HuggingFace小,因此对于标准任务的快速推理,你可能仍需使用专门的服务。价格不是问题——它在Apache 2.0许可下完全开源。总之,SpeechBrain是一个功能强大、可定制的框架,非常适合研究和高级开发。我推荐任何需要完全掌控并构建或微调对话式AI系统的团队使用。请访问https://speechbrain.github.io/自行探索。










评论