
Premières impressions et prise en main
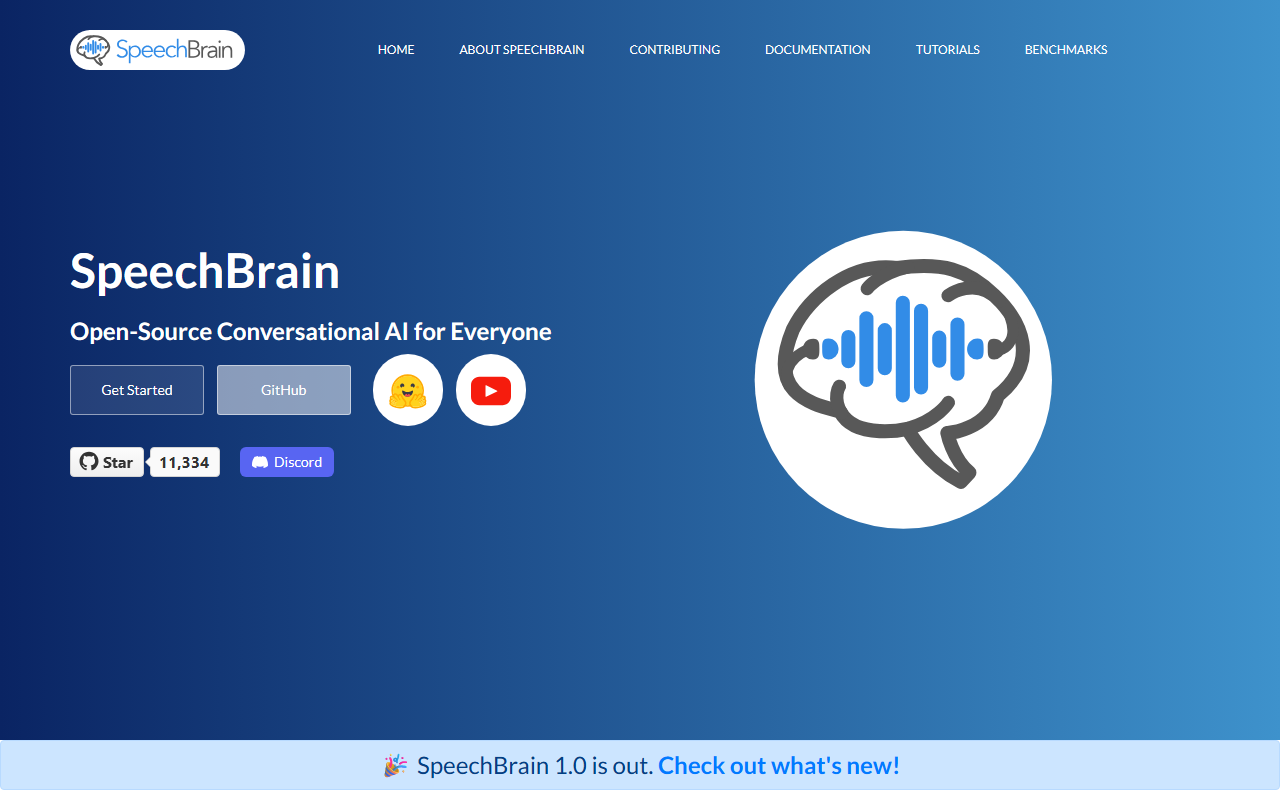
En visitant le site web de SpeechBrain, j'ai été immédiatement frappé par sa clarté et son design orienté développeur. La page d'accueil met en avant la version 1.0, une étape majeure qui signale stabilité et maturité. En tant que framework open source, il n'y a pas d'inscription ni de paiement ; le bouton « Get Started » mène directement aux instructions d'installation. Le tableau de bord (pour ainsi dire) est le dépôt GitHub et le site de documentation. J'ai testé l'offre gratuite — qui constitue l'ensemble du projet — en suivant la commande d'installation via PyPI. En quelques minutes, j'avais un environnement de travail avec accès à des dizaines de recettes pour des tâches comme la reconnaissance vocale, la vérification du locuteur et la synthèse vocale. La configuration basée sur YAML est un atout majeur : les hyperparamètres de chaque recette se trouvent dans un seul fichier, et l'entraînement est lancé avec python train.py hparams/train.yaml. Ce flux de travail rationalisé permet de reproduire facilement les résultats ou d'ajuster les paramètres sans plonger dans un code complexe.
Ce que fait SpeechBrain et la technologie derrière
SpeechBrain est un framework open source complet pour la création de systèmes d'IA conversationnelle. Il couvre la parole (reconnaissance, amélioration, séparation, TTS, reconnaissance du locuteur, traduction parole-à-parole, SLU), l'audio (vocoding, augmentation, extraction de caractéristiques, détection d'événements sonores, beamforming) et le texte (modèles de langage des n-grammes aux LLM). Techniquement, il exploite PyTorch et prend en charge des techniques avancées d'apprentissage profond comme l'apprentissage auto-supervisé, l'apprentissage continu, les modèles de diffusion et les méthodes bayésiennes. La boîte à outils est modulaire : vous pouvez définir des modèles, des pertes et des boucles personnalisés en sous-classant sb.Brain. Cette flexibilité est taillée sur mesure pour la recherche. L'intégration HuggingFace fournit des modèles pré-entraînés pour une inférence rapide, mais la véritable puissance réside dans sa bibliothèque de recettes pour le benchmarking sur des jeux de données comme LibriSpeech, CommonVoice et VoxCeleb. Pour les développeurs, l'installation locale via GitHub donne un accès complet à toutes les recettes et la possibilité de personnaliser n'importe quel composant.
Position sur le marché et alternatives
Contrairement aux services commerciaux comme Google Cloud Speech-to-Text ou AWS Transcribe, SpeechBrain est entièrement gratuit et local, ce qui le rend idéal pour les chercheurs et les équipes soucieuses de la confidentialité. Comparé à d'autres frameworks open source, il se distingue par son ampleur : ESPnet se concentre davantage sur le traitement de la parole de bout en bout, tandis que Kaldi est plus ancien et moins natif PyTorch. Les Transformers de Hugging Face proposent des modèles vocaux mais manquent des recettes d'entraînement intégrées et du support de pipelines multitâches que fournit SpeechBrain. SpeechBrain est le mieux adapté aux laboratoires académiques, aux groupes de R&D et aux développeurs avancés qui ont besoin d'entraîner des modèles personnalisés à partir de zéro ou de les affiner sur des données propriétaires. Il peut submerger les débutants qui préfèrent les API clés en main, bien que les interfaces de modèles pré-entraînés sur HuggingFace aident. Le projet est communautaire avec des collaborateurs du monde académique et industriel, et dispose de canaux Discord et GitHub actifs pour le support.
Points forts, limites et verdict
Le plus grand point fort est son approche holistique : un seul framework gère la parole, l'audio et le texte au sein d'un pipeline unifié. La conception axée sur la reproductibilité — configurations YAML et scripts d'entraînement clairs — est une aubaine pour les chercheurs. La communauté active et les mises à jour fréquentes (v1.0 récemment) indiquent une maintenance saine. Cependant, la courbe d'apprentissage est abrupte. Bien que la documentation soit correcte, les nouveaux venus qui ne sont pas familiers avec PyTorch ou le traitement de la parole peuvent rencontrer des difficultés. De plus, l'écosystème de modèles pré-entraînés est plus petit que celui de HuggingFace, donc pour une inférence rapide sur des tâches standard, vous pourriez encore utiliser un service dédié. Le prix n'est pas un problème — il est entièrement open source sous licence Apache 2.0. En conclusion, SpeechBrain est un framework puissant et personnalisable qui excelle pour la recherche et le développement avancé. Je le recommande à toute équipe ayant besoin de construire ou d'affiner des systèmes d'IA conversationnelle avec un contrôle total. Visitez SpeechBrain à l'adresse https://speechbrain.github.io/ pour l'explorer par vous-même.










Commentaires