
Qu'est-ce qu'arXiv et comment ça marche ?
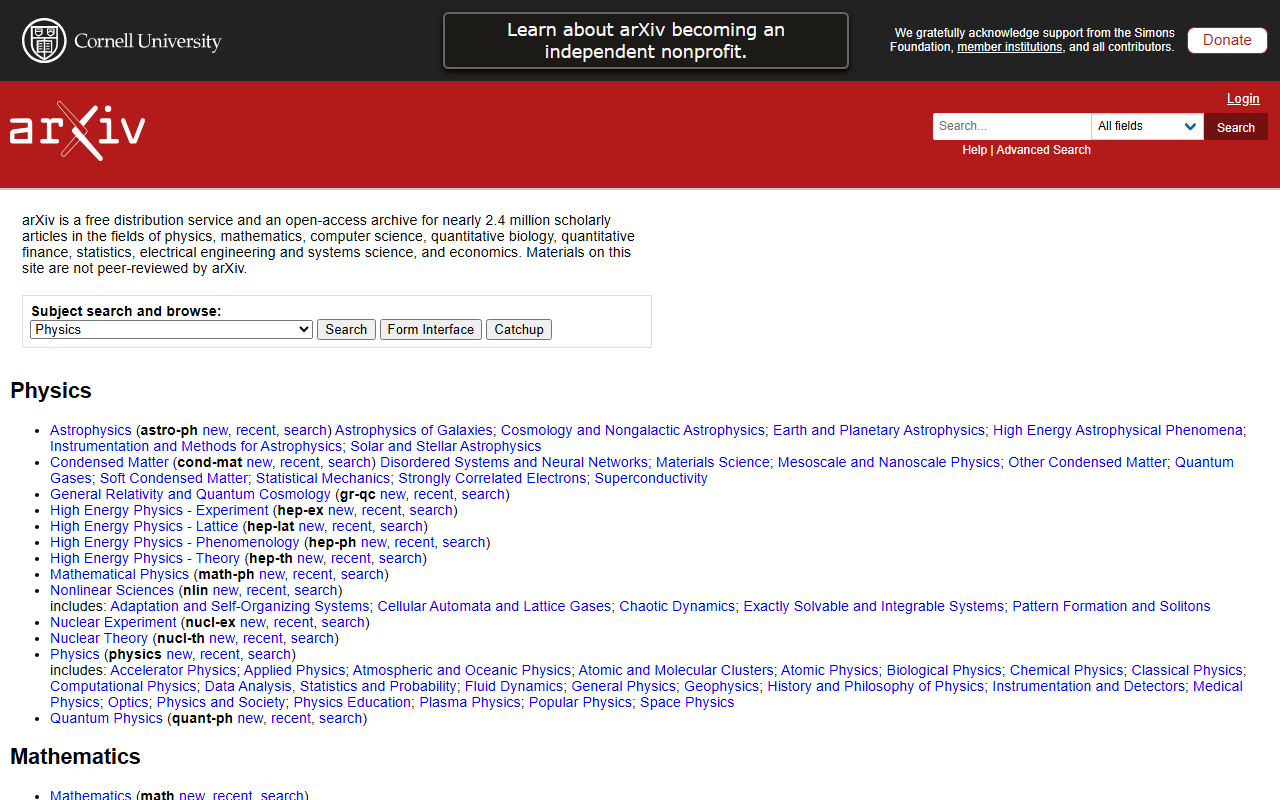
En visitant le site arXiv à https://arxiv.org/, vous êtes accueilli par une interface minimaliste et riche en texte qui privilégie la fonctionnalité à l'esthétique. La page d'accueil présente une simple barre de recherche et une liste de catégories thématiques : Physique, Mathématiques, Informatique, Biologie quantitative, etc. Le tableau de bord est essentiellement un portail donnant accès à près de 2,4 millions d'articles savants, tous librement accessibles. En tant que chercheur ou passionné d'IA, c'est ici que vous trouverez les derniers travaux sur l'apprentissage automatique, le traitement du langage naturel et la vision par ordinateur – souvent des mois avant leur publication officielle.
arXiv n'est pas un outil d'IA au sens traditionnel – il ne génère pas de texte ni n'analyse de données. Il s'agit plutôt d'un service de distribution et d'une archive en libre accès. Les documents sur ce site ne sont pas évalués par les pairs par arXiv, ce qui est un point crucial : vous obtenez la recherche brute, non filtrée. C'est à la fois sa force et sa limite. En testant l'offre gratuite (il n'existe pas d'offre payante), j'ai recherché « transformer » et j'ai instantanément trouvé plus de 10 000 résultats, bien triés par date. Les options de recherche avancée permettent de filtrer par titre, auteur, résumé, etc., ce qui rend la navigation simple.
Analyse approfondie : fonctionnalités et flux de travail
La fonctionnalité principale d'arXiv est son archive complète. Elle couvre les disciplines de l'informatique, notamment l'intelligence artificielle, l'apprentissage automatique, la vision par ordinateur, le calcul et le langage, et bien d'autres. La fonction de navigation vous permet de voir les nouvelles soumissions, les articles récents ou de rechercher dans une sous-catégorie spécifique. Par exemple, sous cs.LG (Machine Learning), vous pouvez voir les listes quotidiennes de nouveaux prépublications. J'ai cliqué sur « new » pour cs.AI et j'ai vu une liste d'articles avec des titres, des auteurs et des résumés. Chaque article propose plusieurs formats : PDF, HTML et fichiers sources.
Un flux de travail notable est la possibilité de s'abonner à des flux RSS ou à des alertes par e-mail pour des catégories spécifiques. Cela permet aux chercheurs de rester informés sans consulter le site quotidiennement. De plus, arXiv fournit une API pour un accès programmatique, que de nombreux agrégateurs tiers et outils académiques utilisent pour construire des listes de lecture personnalisées. Cependant, arXiv lui-même n'offre aucune aide à la lecture, aucun résumé ni annotation basée sur l'IA. L'interface est purement archivistique. Cela dit, sa valeur réside dans le fait d'être le premier point de découverte de la recherche de pointe.
Tarifs, technologie et intégrations
arXiv est totalement gratuit pour les lecteurs. Il n'y a pas de niveaux d'abonnement, ni de fonctionnalités premium. Le service est soutenu par des dons d'institutions telles que la Simons Foundation et d'organisations membres. Les frais de soumission sont également gratuits pour les auteurs de la plupart des institutions, bien que certaines adhésions couvrent les frais de soumission. Cette ouverture est un avantage majeur par rapport aux dépôts payants.
Technologiquement, arXiv est une base de données simple avec des capacités de recherche. Il ne fonctionne pas sur un grand modèle de langage ni aucune IA générative. Si vous cherchez des outils d'IA pour résumer ou analyser des articles, vous devrez associer arXiv à des services externes comme Scholarcy ou Connected Papers. arXiv offre bien une API (documentée sur son site) pour les téléchargements automatisés et la récupération de métadonnées. Les intégrations sont courantes via des outils comme Zotero et Mendeley, qui peuvent importer directement des articles d'arXiv.
Contrairement aux services commerciaux tels que Google Scholar ou Semantic Scholar, arXiv n'est pas un index de citations ; c'est un serveur de prépublications. Il ne fournit pas de comptes de citations, de suggestions d'articles connexes basées sur des embeddings, ni de flux organisés par IA. Sa technologie est basique mais robuste pour son objectif.
Qui devrait utiliser arXiv ?
arXiv est indispensable pour les chercheurs académiques, les doctorants et les professionnels en IA, physique et mathématiques. C'est le moyen le plus rapide d'accéder aux dernières recherches sans attendre la publication dans une revue. Cependant, il ne convient pas à ceux qui recherchent un contenu organisé et évalué par les pairs, ni aux lecteurs occasionnels qui souhaitent des résumés. Les consommateurs généraux à la recherche d'outils d'IA pour les aider à lire des articles pourraient trouver arXiv écrasant en raison de son volume pur et de l'absence de filtrage intelligent.
Parmi les alternatives, on trouve Google Scholar (plus vaste, mais inclut des articles évalués par les pairs et davantage de contexte) et Semantic Scholar (recherche et recommandations basées sur l'IA). Les principaux concurrents d'arXiv sont d'autres serveurs de prépublications comme bioRxiv, mais pour l'IA, arXiv est la plateforme dominante. Une réelle limitation est l'absence d'aide à la lecture – pas de résumé intégré, pas d'extraction de termes clés. Vous devez lire les PDF vous-même. De plus, les soumissions n'étant pas évaluées par les pairs, la qualité varie considérablement, et il n'y a pas de contrôle qualité automatisé au-delà du filtrage anti-spam.
Pour les chercheurs en IA, arXiv est essentiel. Pour tous les autres, c'est une ressource brute qui demande de la patience. Si vous êtes sérieux au sujet de rester à jour en IA, vous devez utiliser arXiv. Ma recommandation : commencez par vous abonner aux flux RSS cs.AI et cs.LG, et utilisez un outil tiers comme Arxiv Sanity ou Papers With Code pour améliorer votre expérience de lecture.
Visitez arXiv à https://arxiv.org/ pour l'explorer par vous-même.


Commentaires