
arXiv란 무엇이며 어떻게 작동합니까?
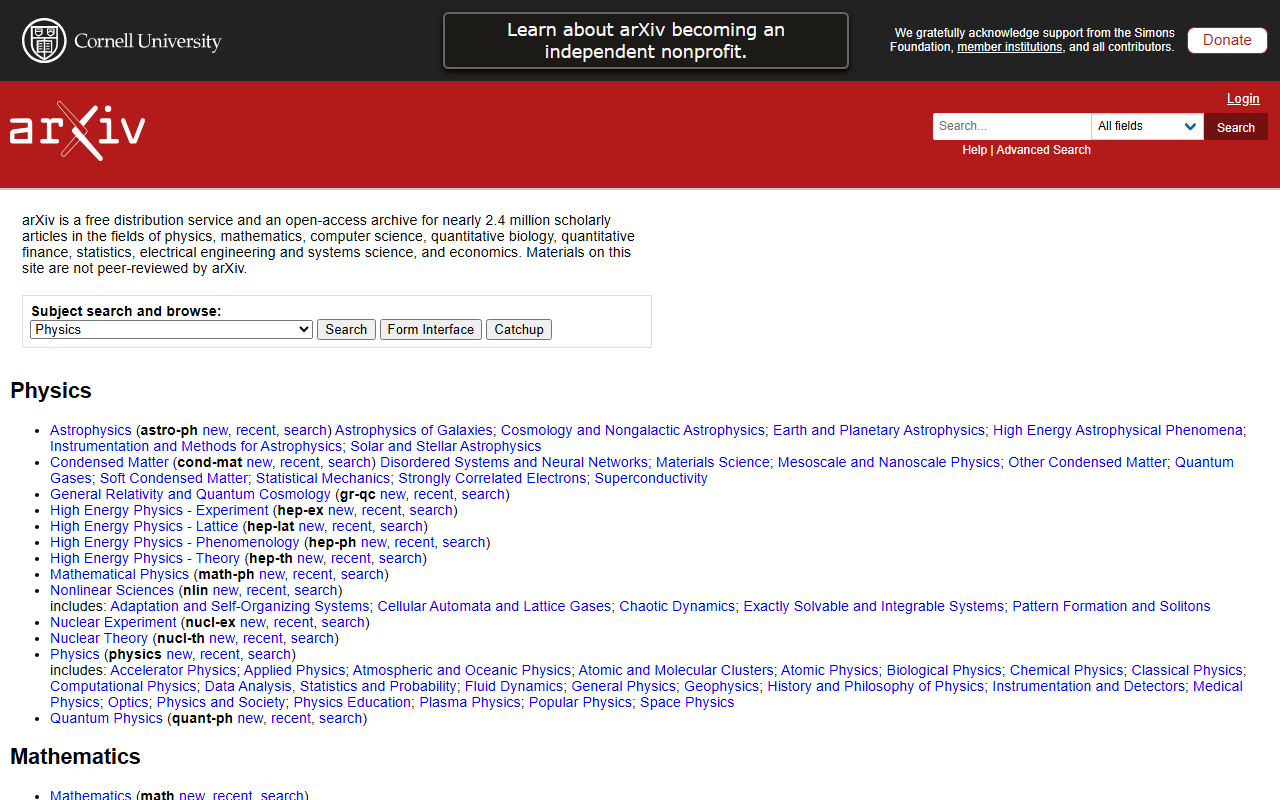
arXiv 웹사이트(https://arxiv.org/)를 방문하면 기능을 형태보다 우선시하는 미니멀하고 텍스트 위주의 인터페이스를 만나게 됩니다. 홈페이지에는 간단한 검색창과 물리학, 수학, 컴퓨터 과학, 정량 생물학 등 주제 카테고리 목록이 표시됩니다. 대시보드는 사실상 약 240만 개의 학술 논문에 자유롭게 접근할 수 있는 포털입니다. AI 연구자나 애호가로서, 이곳에서 머신러닝, 자연어 처리, 컴퓨터 비전에 관한 최신 연구를 공식 출판보다 몇 달 먼저 찾을 수 있습니다.
arXiv는 전통적인 의미의 AI 도구가 아닙니다. 텍스트를 생성하거나 데이터를 분석하지 않습니다. 대신, 배포 서비스이자 오픈 액세스 아카이브입니다. 이 사이트의 자료는 arXiv에 의해 동료 검토(peer review)되지 않는다는 점이 중요합니다. 즉, 가공되지 않고 검증되지 않은 연구를 접하게 됩니다. 이것이 arXiv의 강점이자 한계입니다. 무료 티어(유료 티어는 없음)를 테스트할 때 'transformer'를 검색했고, 10,000개 이상의 결과를 날짜별로 정리된 상태로 즉시 찾을 수 있었습니다. 고급 검색 옵션을 사용하면 제목, 저자, 초록 등으로 필터링할 수 있어 탐색이 간편합니다.
심층 분석: 기능 및 워크플로
arXiv의 핵심 기능은 포괄적인 아카이브입니다. 인공지능, 머신러닝, 컴퓨터 비전, 계산 및 언어 등 컴퓨터 과학 분야를 다룹니다. Browse 기능을 사용하면 새로운 제출물, 최근 논문을 보거나 특정 하위 카테고리 내에서 검색할 수 있습니다. 예를 들어 cs.LG(머신러닝)에서는 매일 새로운 프리프린트 목록을 볼 수 있습니다. 저는 cs.AI의 'new'를 클릭하여 제목, 저자, 초록이 포함된 논문 목록을 확인했습니다. 각 논문은 PDF, HTML, 소스 파일 등 여러 형식으로 연결됩니다.
주목할 만한 워크플로는 특정 카테고리에 대한 RSS 피드나 이메일 알림을 구독할 수 있는 기능입니다. 이를 통해 연구자들은 매일 사이트를 확인하지 않고도 업데이트를 받을 수 있습니다. 또한 arXiv는 프로그래밍 방식 액세스를 위한 API를 제공하며, 많은 타사 집계 도구와 학술 도구가 이를 사용하여 맞춤형 읽기 목록을 구축합니다. 하지만 arXiv 자체는 읽기 지원, 요약, AI 기반 주석 기능을 제공하지 않습니다. 인터페이스는 순수하게 아카이브 용도입니다. 그럼에도 불구하고, 최첨단 연구를 처음 발견하는 지점으로서 그 가치는 큽니다.
가격, 기술 및 통합
arXiv는 독자에게 완전히 무료입니다. 구독 등급이나 프리미엄 기능이 없습니다. 서비스는 Simons Foundation 및 회원 기관과 같은 기관의 기부로 지원됩니다. 대부분의 기관 소속 저자에게 제출도 무료이며, 일부 회원 기관은 제출 수수료를 부담합니다. 이러한 개방성은 유료 장벽이 있는 저장소에 비해 큰 장점입니다.
기술적으로 arXiv는 검색 기능을 갖춘 간단한 데이터베이스입니다. 대규모 언어 모델이나 생성형 AI로 실행되지 않습니다. 논문을 요약하거나 분석할 AI 도구를 찾고 있다면 Scholarcy 또는 Connected Papers와 같은 외부 서비스와 arXiv를 함께 사용해야 합니다. arXiv는 자동 다운로드 및 메타데이터 검색을 위한 API(사이트에 문서화됨)를 제공합니다. Zotero 및 Mendeley와 같은 도구를 통한 통합이 일반적이며, 이들은 arXiv 논문을 직접 가져올 수 있습니다.
Google Scholar나 Semantic Scholar 같은 상업 서비스와 달리 arXiv는 인용 색인이 아닌 프리프린트 서버입니다. 인용 횟수, 임베딩 기반 관련 논문 제안, AI 큐레이팅 피드를 제공하지 않습니다. 기술은 기본적이지만 목적에 맞게 견고합니다.
arXiv는 누구에게 적합한가?
arXiv는 학술 연구자, 박사 과정 학생, AI, 물리학, 수학 분야 전문가에게 없어서는 안 될 도구입니다. 저널 출판을 기다리지 않고 최신 연구에 접근할 수 있는 가장 빠른 방법입니다. 하지만 큐레이팅되고 동료 검토된 콘텐츠를 원하거나 요약을 원하는 일반 독자에게는 적합하지 않습니다. 논문 읽기를 위한 AI 도구를 찾는 일반 소비자는 방대한 양과 지능형 필터링 부재로 인해 arXiv가 부담스러울 수 있습니다.
대안으로는 Google Scholar(더 광범위하지만 동료 검토 및 더 많은 맥락 포함)와 Semantic Scholar(AI 기반 검색 및 추천)가 있습니다. arXiv의 주요 경쟁자는 bioRxiv와 같은 다른 프리프린트 서버이지만, AI 분야에서는 arXiv가 지배적인 플랫폼입니다. 실제 한계는 읽기 지원이 전혀 없다는 점입니다. 내장된 요약 기능이나 핵심 용어 추출이 없습니다. PDF를 직접 읽어야 합니다. 또한 제출물이 동료 검토를 거치지 않기 때문에 품질 편차가 심하고, 스팸 필터링 외에 자동 품질 검사가 없습니다.
AI 연구자에게 arXiv는 필수적입니다. 그 외 사용자에게는 인내심이 필요한 원시 자료입니다. AI 분야의 최신 동향을 진지하게 따라가려면 arXiv를 사용해야 합니다. 제 추천은 cs.AI 및 cs.LG RSS 피드를 구독하고, Arxiv Sanity 또는 Papers With Code 같은 타사 도구를 사용하여 읽기 경험을 향상시키는 것입니다.
직접 탐색하려면 https://arxiv.org/에서 arXiv를 방문하세요.


댓글