
arXivとは?その仕組みと使い方
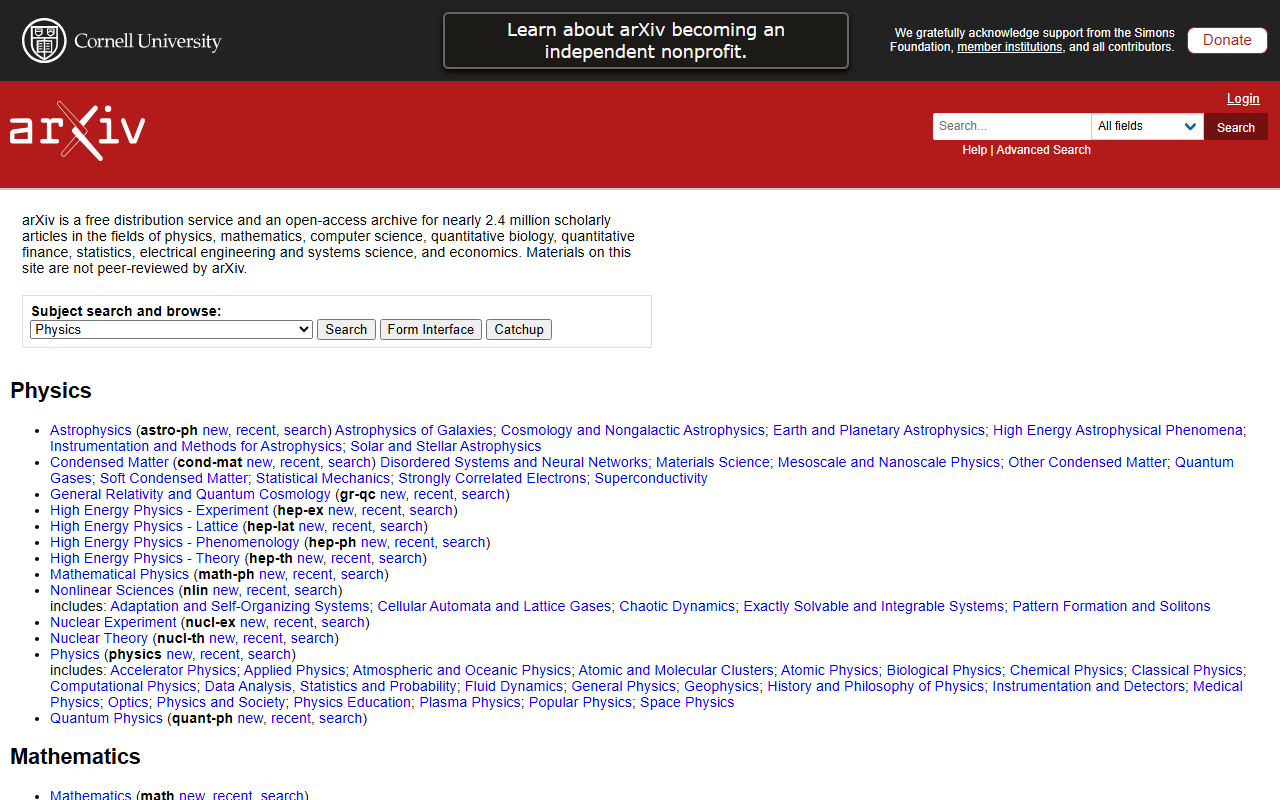
arXivのウェブサイト(https://arxiv.org/)にアクセスすると、機能性を重視したミニマルでテキスト主体のインターフェースが表示されます。ホームページにはシンプルな検索バーと、物理学、数学、コンピュータサイエンス、定量生物学などの分野カテゴリ一覧が表示されます。このダッシュボードは、約240万件の学術論文へのポータルであり、すべて無料でアクセスできます。AIの研究者や愛好家にとって、ここは機械学習、自然言語処理、コンピュータビジョンに関する最新の研究成果を、公式発表より数か月早く見つけられる場所です。
arXivは従来のAIツールではありません。テキストを生成したりデータを分析したりするわけではなく、配信サービスおよびオープンアクセスアーカイブです。このサイトの資料はarXivによる査読を受けていません。これが重要なポイントです。生の、未検証の研究を入手できるのです。それが強みであり、限界でもあります。無料プラン(有料プランはありません)を試すにあたって、"transformer"を検索したところ、1万件以上の結果が即座に表示され、日付順にきれいに整理されていました。高度な検索オプションでは、タイトル、著者、抄録などでフィルタリングでき、ナビゲーションはわかりやすいです。
詳細:機能とワークフロー
arXivの核となる機能は、その包括的なアーカイブです。カバーするコンピュータサイエンス分野には、人工知能、機械学習、コンピュータビジョン、計算と言語などが含まれます。ブラウズ機能を使えば、新しい投稿、最近の論文、特定のサブカテゴリ内の検索が可能です。たとえば、cs.LG(機械学習)では、新しいプレプリントの日次リストを確認できます。cs.AIの"new"をクリックすると、タイトル、著者、抄録が表示された論文一覧が表示されます。各論文はPDF、HTML、ソースファイルなど複数の形式にリンクされています。
注目すべきワークフローは、RSSフィードや特定カテゴリのメールアラートを購読できることです。これにより、毎日サイトをチェックしなくても最新情報を得られます。さらに、arXivはAPIを提供しており、多数のサードパーティのアグリゲーターや学術ツールがこれを利用してカスタムの読書リストを構築しています。ただし、arXiv自体には読書支援、要約、AIによる注釈などの機能はありません。インターフェースは純粋にアーカイブ用です。とはいえ、最先端の研究を最初に発見できる場としての価値は大きいです。
価格、技術、統合
arXivは読者にとって完全に無料です。サブスクリプションプランやプレミアム機能はありません。このサービスは、サイモンズ財団や加盟機関からの寄付によって支えられています。投稿者側の価格も、ほとんどの機関では無料で、一部のメンバーシップが投稿料をカバーしています。このオープンさは、ペイウォールがあるリポジトリに対する大きな利点です。
技術的には、arXivは検索機能を備えたシンプルなデータベースです。大規模言語モデルや生成AIを利用していません。論文の要約や分析を支援するAIツールをお探しなら、arXivをScholarcyやConnected Papersのような外部サービスと組み合わせる必要があります。arXivはAPI(サイトにドキュメントあり)を提供しており、自動ダウンロードやメタデータ取得が可能です。ZoteroやMendeleyなどのツールと統合して、arXivの論文を直接取り込むことも一般的です。
Google ScholarやSemantic Scholarのような商業サービスとは異なり、arXivは引用インデックスではなく、プレプリントサーバーです。引用数、埋め込みに基づく関連論文の提案、AIによる厳選フィードなどは提供しません。その技術は基本的ですが、目的に対して堅牢です。
誰がarXivを使うべきか
arXivは、学術研究者、博士課程の学生、AI・物理学・数学の専門家にとって不可欠です。ジャーナル掲載を待たずに最新の研究にアクセスする最も早い方法です。ただし、厳選された査読済みコンテンツを求める方や、要約を読みたい一般読者には適していません。論文を読むためのAIツールを探している一般消費者にとって、arXivは情報量が多すぎ、インテリジェントなフィルタリングがないため、圧倒される可能性があります。
代替手段としては、Google Scholar(より広範で、査読済みのコンテキストも含む)やSemantic Scholar(AIによる検索とレコメンデーション)があります。arXivの主な競合はbioRxivなどの他のプレプリントサーバーですが、AI分野ではarXivが支配的です。実際の制限は、読書支援機能が一切ないことです。内蔵の要約やキーワード抽出はなく、自分でPDFを読む必要があります。また、投稿内容は査読されていないため、品質にばらつきが大きく、スパムフィルタリング以外の自動品質チェックはありません。
AI研究者にとって、arXivは必須です。それ以外の人にとっては、忍耐を要する生のリソースです。AIの最新情報を追いかけるなら、arXivを使う必要があります。私の推奨は、まずcs.AIとcs.LGのRSSフィードを購読し、Arxiv SanityやPapers With Codeなどのサードパーティツールを利用して読書体験を向上させることです。
詳しくは、arXivのウェブサイト(https://arxiv.org/)をご覧ください。


コメント