

첫인상 및 온보딩
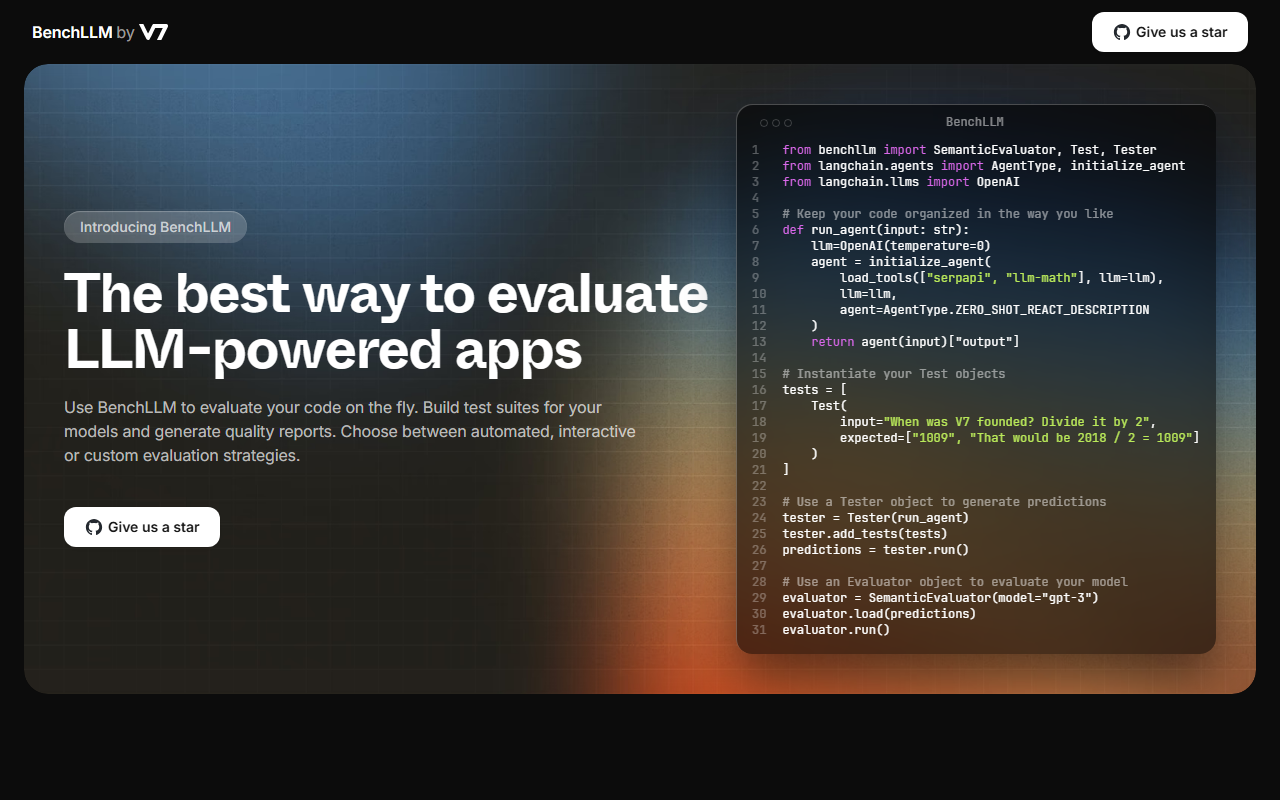
BenchLLM 웹사이트에 방문했을 때, 깔끔하고 코드 중심의 랜딩 페이지가 즉시 대상 사용자가 AI 엔지니어임을 알려주었습니다. 히어로 섹션에는 「LLM 기반 앱을 평가하는 최고의 방법」이라고 적혀 있고, GitHub 저장소로 연결되는 별표 버튼이 있어 오픈소스 프로젝트임을 분명히 나타냅니다. 페이지는 마케팅용 잡담에 시간을 낭비하지 않고, 바로 라이브러리를 사용한 전체 코드 예제를 보여주며 benchllm과 langchain의 임포트까지 포함되어 있습니다. 이러한 투명성은 개발자 도구로서 신선합니다. 방문한 지 몇 초 만에 API를 이해할 수 있었습니다.
온보딩 흐름은 최소한입니다. 웹사이트에 회원가입이나 대시보드가 없습니다. 대신 사용자는 GitHub 저장소로 안내되며 pip를 통해 설치합니다. 무료 티어(오픈소스이므로 전체 도구)를 테스트할 때, 저장소를 클론하고 제공된 예제를 사용하여 간단한 평가를 실행했습니다. CLI 명령어 $ bench run tests/hallucinations는 테스트 결과, 실패 및 실행 시간을 보여주는 깔끔한 형식의 테이블을 생성했습니다. 출력에는 입력, 실제 출력, 예상 값이 포함되어 있어 한눈에 실패를 확인하기 쉽습니다. 이러한 즉각적인 피드백 루프는 제가 개발 프레임워크에서 찾는 바로 그것입니다.
핵심 기능 및 워크플로
BenchLLM은 테스트 스위트를 구축하고, 예측을 생성하며, 이를 자동으로 평가하여 LLM 기반 앱을 평가하도록 설계되었습니다. 핵심 워크플로는 세 가지 주요 클래스인 Test, Tester, SemanticEvaluator를 중심으로 이루어집니다. Test 객체는 입력 문자열과 예상 출력 목록(여러 정답 허용)으로 정의합니다. 그런 다음 에이전트 함수(문자열을 반환하는 모든 호출 가능 객체)를 전달하여 Tester를 인스턴스화하고 테스트를 추가한 후 실행하여 예측을 얻습니다. 마지막으로 해당 예측을 SemanticEvaluator에 로드하면, 이 평가기가 언어 모델(예: GPT-3)을 사용하여 출력이 예상 결과와 일치하는지 판단합니다. 이 접근 방식은 단순한 문자열 매칭을 의미론적 이해로 대체하며, 이는 표현 방식이 다양할 수 있는 LLM 출력에 매우 중요합니다.
프레임워크는 또한 대화형 및 맞춤형 평가 전략을 지원하지만, 웹사이트에서는 자동 의미론적 경로만 보여줍니다. 주목할 만한 기능은 결과를 캐시하고 상세한 테이블로 실패를 표시하는 CLI 통합 테스트 실행기입니다. 홈페이지에 표시된 예제는 할루시네이션 시나리오를 테스트합니다. 이벤트 전에 2024년 올림픽에 대해 묻는 경우로, 예상 답변은 「모르겠습니다」입니다. CLI 출력은 실패를 명확히 표시합니다. BenchLLM은 기본적으로 LangChain 에이전트를 활용하지만, 모든 함수를 통합할 수 있습니다. 이 라이브러리는 엔지니어에 의해 엔지니어를 위해 구축되었습니다. 코드 스니펫은 Python 타입 힌트와 현대적인 패턴을 사용합니다. 또한 이 프로젝트는 GitHub에서 별표 요청과 함께 커뮤니티가 성장하고 있음을 확인했는데, 이는 장기적인 지원을 위한 좋은 신호입니다.
가격 및 시장 포지션
BenchLLM은 완전히 오픈소스입니다. 유료 티어가 없으므로 웹사이트에 가격이 공개되어 있지 않습니다. 오픈소스 라이선스에 따라 무료로 사용할 수 있습니다. 하지만 웹사이트에 라이선스 파일이 명시되어 있지는 않지만, 프로젝트는 GitHub에 호스팅되어 있으며(MIT 라이선스임을 확인했습니다). 이는 BenchLLM을 개인 개발자와 스타트업에게 매우 접근하기 쉽게 만듭니다. LangSmith나 Weights & Biases Prompts와 같은 엔터프라이즈 솔루션과 비교할 때, BenchLLM은 클라우드 대시보드 없이 더 가볍고 코드 중심적인 경험을 제공합니다. 또 다른 대안으로 DeepEval이 있으며, 이 역시 오픈소스이지만 내장 메트릭을 사용한 단위 테스트에 중점을 둡니다. BenchLLM은 유연한 Tester/Evaluator 패턴과 pytest와 같은 전통적인 테스트 프레임워크를 모방한 CLI를 통해 의미론적 평가에 초점을 맞춤으로써 차별화됩니다.
「AI 엔지니어에 의해 AI 엔지니어를 위한」 도구로 포지셔닝된 BenchLLM은 LLM 평가를 CI/CD 파이프라인에 직접 통합하려는 개발자에게 가장 적합합니다. 비기술 팀이나 코드 없는 평가 대시보드를 원하는 사용자를 대상으로 하지 않습니다. 호스팅된 UI가 없다는 점이 일부 사용자를 막을 수 있지만, 그 대가로 완전한 제어권을 얻을 수 있습니다. 이 프로젝트는 비교적 새로운 것으로 보입니다. GitHub 저장소의 별표와 기여자 수가 많지 않아 일부 미흡한 점이나 문서 부족을 겪을 수 있습니다. 그러나 핵심 기능은 특히 소규모 및 중간 규모 프로젝트에서 프로덕션 사용에 충분히 성숙했습니다.
최종 평결
장점: BenchLLM은 기존 Python 프로젝트와 원활하게 통합되는 깔끔하고 직관적인 API를 제공합니다. 의미론적 평가기는 정확한 매칭으로 인한 거짓 양성을 줄여줍니다. CLI 출력은 디버깅에 탁월합니다. 또한 오픈소스이므로 비용이 전혀 들지 않고 완전한 사용자 정의가 가능합니다.
한계: 현재 이 도구는 기본적으로 Python 및 LangChain 에이전트로 제한됩니다. 의미론적 평가기는 타사 모델(예: GPT-3)에 의존하므로 사용 비용이 발생하고 API 키가 필요합니다. Anthropic이나 Cohere와 같은 다른 LLM 제공업체에 대한 기본 지원은 없지만, 맞춤형 평가기를 작성할 수 있습니다. 프로젝트가 아직 초기 단계이므로 커뮤니티 지원과 문서화가 더 확립된 도구만큼 광범위하지 않습니다.
추천: LLM 애플리케이션을 개발 중이고 로컬 또는 CI 파이프라인에서 실행할 수 있는 가볍고 스크립트 가능한 평가 프레임워크가 필요한 개발자라면 BenchLLM을 시도해보십시오. 특히 Python 전문성이 있으며 할루시네이션, 사실성 또는 예상 출력 준수 여부를 테스트하려는 팀에 강력합니다. 코드 없는 대시보드, 비Python 언어 지원 또는 올인원 관리형 플랫폼이 필요하다면 다른 곳을 찾아보십시오. 직접 알아보려면 https://benchllm.com/에서 BenchLLM을 방문하십시오.


댓글