

第一印象とオンボーディング
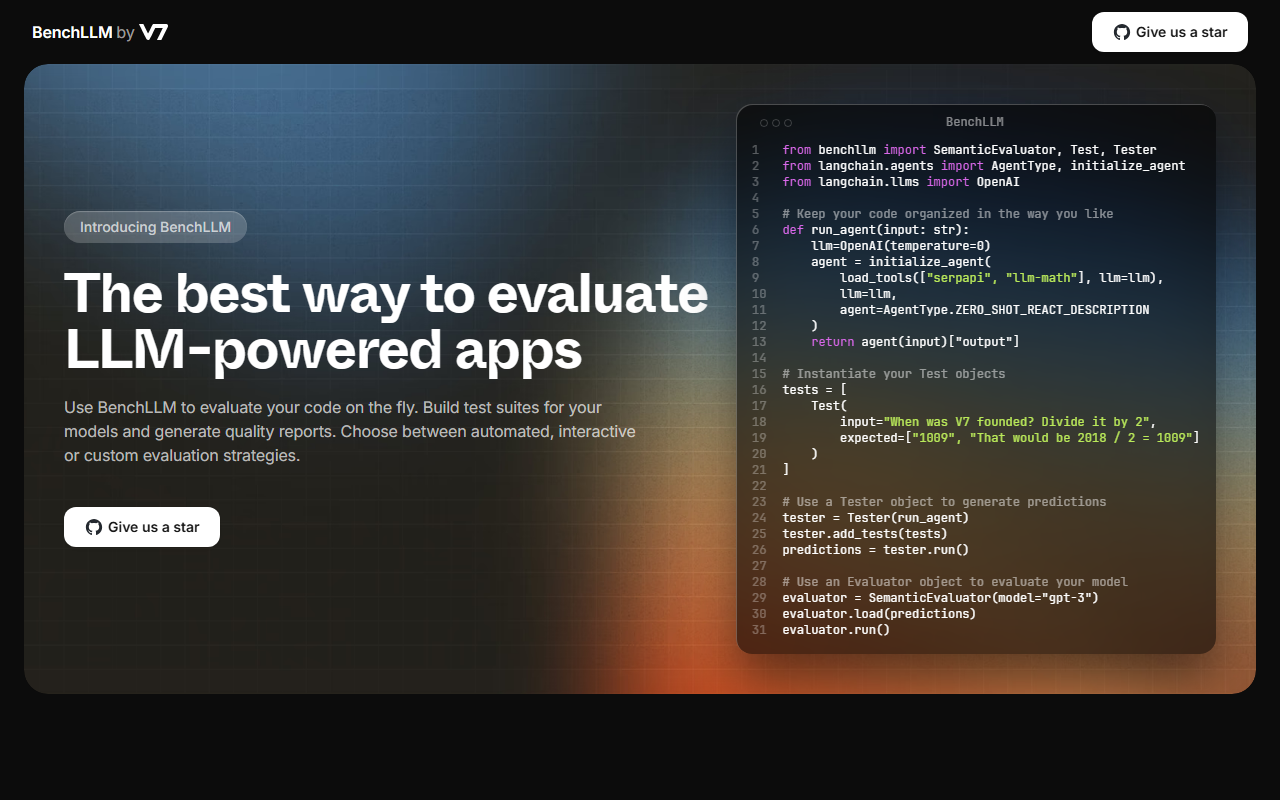
BenchLLMのウェブサイトを訪れると、まずコードを前面に押し出したクリーンなランディングページが目に入ります。それはすぐにターゲットユーザーがAIエンジニアであることを示しています。ヒーローセクションには「LLMを活用したアプリを評価する最良の方法」と誇らしげに書かれ、GitHubリポジトリへのスターリクエストボタンも設置されています。これはオープンソースプロジェクトであることを明確に示しています。このページはマーケティングの無駄を一切排し、代わりにbenchllmとlangchainからのインポートを含む完全なコード例をいきなり提示します。この透明性は開発者向けツールとしては新鮮で、私はアクセスしてから数秒でAPIを理解し始めることができました。
オンボーディングの流れは最小限です。ウェブサイトにはサインアップやダッシュボードはありません。代わりにユーザーはGitHubリポジトリに誘導され、pipでインストールします。無料のティア(このツールはオープンソースなので全体が無料)をテストする際、リポジトリをクローンし、提供されたサンプルを使って簡単な評価を実行しました。CLIコマンド「$ bench run tests/hallucinations」を実行すると、テスト結果、失敗、実行時間を表示する整然とした表が出力されます。出力には入力、実際の出力、期待値が含まれており、失敗箇所を一目で確認できます。この即時フィードバックループは、開発フレームワークにまさに求めるものです。
コア機能とワークフロー
BenchLLMは、テストスイートを構築し、予測を生成し、それらを自動評価することで、LLM搭載アプリを評価するよう設計されています。コアワークフローは3つの主要クラス、Test、Tester、SemanticEvaluatorを中心に構成されています。まず、Testオブジェクトを入力文字列と期待される出力のリスト(複数の正解を許可)で定義します。次に、エージェント関数(文字列を返す任意の呼び出し可能オブジェクト)を渡してTesterをインスタンス化し、テストを追加して実行し予測を取得します。最後に、その予測をSemanticEvaluatorにロードします。これは言語モデル(GPT-3など)を使用して出力が期待結果と一致するかどうかを判断します。このアプローチは、単純な文字列一致を意味理解に置き換えるもので、表現が変わる可能性のあるLLM出力には不可欠です。
フレームワークは対話型評価とカスタム評価戦略もサポートしていますが、ウェブサイトでは自動セマンティックパスのみが示されています。注目すべき機能は、CLIに統合されたテストランナーで、結果をキャッシュし、詳細な表で失敗を表示します。ホームページの例では、ハルシネーションシナリオをテストしています。2024年オリンピックについてイベント前に質問し、期待される回答は「知りません」です。CLI出力は失敗を明確に示します。BenchLLMは標準でLangChainエージェントを活用しますが、任意の関数を統合することもできます。このライブラリはエンジニアによってエンジニアのために構築されています。コードスニペットはPythonの型ヒントとモダンなパターンを使用しています。また、このプロジェクトはGitHubで成長中のコミュニティがあり、スターリクエストがあることから、長期的なサポートが期待できる良い兆候です。
価格と市場での位置づけ
BenchLLMは完全にオープンソースです。ウェブサイトに価格は公開されていません。有料プランが存在しないため、オープンソースライセンスのもとで無料で使用できます。ただし、ウェブサイトにはライセンスファイルの記載はありませんが、GitHubでホストされており、私はMITライセンスであることを確認しました。これにより、BenchLLMは個人の開発者やスタートアップにとって非常にアクセスしやすいものになっています。LangSmithやWeights & Biases Promptsなどのエンタープライズソリューションと比較すると、BenchLLMはクラウドダッシュボードなしで、より軽量でコード中心の体験を提供します。もう1つの代替案であるDeepEvalもオープンソースですが、組み込みメトリクスを使ったユニットテストに重点を置いています。BenchLLMは、柔軟なTester/Evaluatorパターンとpytestのような従来のテストフレームワークを模倣したCLIにより、セマンティック評価に焦点を当てることで差別化を図っています。
「AIエンジニアによるAIエンジニアのための」ツールとして位置づけられるBenchLLMは、LLM評価をCI/CDパイプラインに直接統合したい開発者に最適です。非技術チームやノーコードの評価ダッシュボードを求める人には向いていません。ホスト型UIがないことは一部のユーザーを遠ざけるかもしれませんが、その代わりに完全な制御を得られます。このプロジェクトは比較的新しく、GitHubリポジトリのスター数やコントリビューター数は控えめであり、荒削りな部分や不足しているドキュメントに遭遇する可能性があります。しかし、コア機能は特に小中規模プロジェクトにおいて本番使用に十分成熟しています。
最終評価
強み: BenchLLMはクリーンで直感的なAPIを提供し、既存のPythonプロジェクトにシームレスに統合できます。セマンティック評価ツールは、完全一致によって生じる誤検出を低減します。CLI出力はデバッグに非常に優れています。また、オープンソースであるため、コストゼロで完全なカスタマイズが可能です。
制限事項: 現時点では、このツールは標準でPythonとLangChainエージェントに限定されています。セマンティック評価ツールはサードパーティモデル(例:GPT-3)に依存しており、使用料が発生し、APIキーが必要です。評価用にAnthropicやCohereなどの他のLLMプロバイダーをネイティブサポートしていませんが、カスタム評価ツールを作成することは可能です。プロジェクトはまだ若いため、コミュニティサポートやドキュメントは、より確立されたツールほど充実していません。
推奨: LLMアプリケーションを構築する開発者で、ローカルまたはCIパイプラインで実行できる軽量でスクリプト可能な評価フレームワークが必要なら、BenchLLMを試してみてください。特に、ハルシネーション、事実性、期待される出力への準拠をテストしたいPythonに精通したチームに強みがあります。ノーコードダッシュボード、非Python言語のサポート、オールインワンのマネージドプラットフォームが必要な場合は、別のツールを検討してください。詳細はhttps://benchllm.com/ でご確認ください。


コメント