

Premières impressions et prise en main
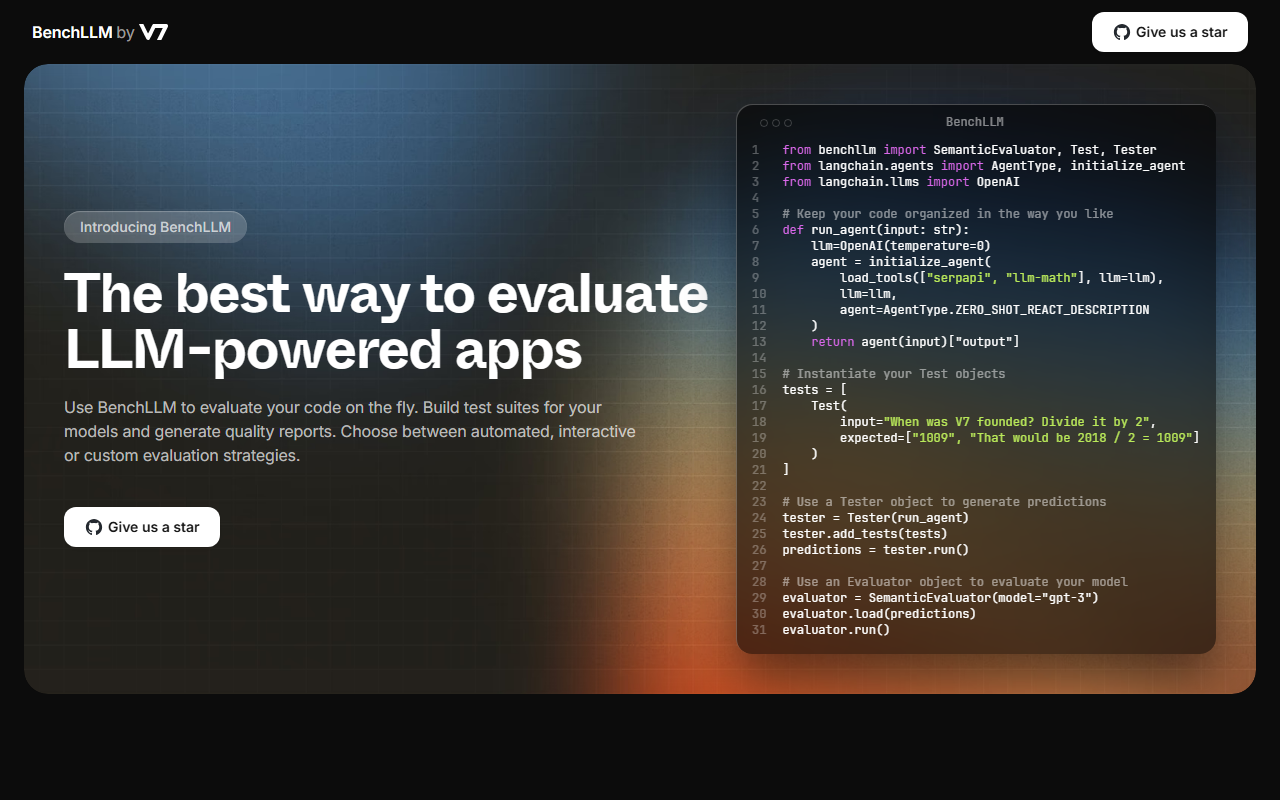
En visitant le site Web de BenchLLM, j'ai été accueilli par une page d'atterrissage propre et orientée code qui signale immédiatement son public cible : les ingénieurs en IA. La section héros proclame fièrement : « La meilleure façon d'évaluer les applications propulsées par LLM » et inclut un bouton étoile pour le dépôt GitHub – un indicateur clair qu'il s'agit d'un projet open-source. La page ne perd pas de temps en marketing inutile ; au lieu de cela, elle plonge directement dans un exemple de code complet utilisant la bibliothèque, avec des imports de benchllm et langchain. Cette transparence est rafraîchissante pour un outil de développeur. J'ai pu commencer à comprendre l'API en quelques secondes après mon arrivée.
Le flux de prise en main est minimal – il n'y a pas d'inscription ni de tableau de bord sur le site. Au lieu de cela, les utilisateurs sont dirigés vers le dépôt GitHub et installé via pip. En testant le niveau gratuit (qui est l'outil entier puisqu'il est open-source), j'ai cloné le dépôt et exécuté une évaluation simple en utilisant l'exemple fourni. La commande CLI $ bench run tests/hallucinations a produit un tableau bien formaté montrant les résultats des tests, les échecs et le temps d'exécution. La sortie inclut l'entrée, la sortie réelle et les valeurs attendues, ce qui facilite la détection des échecs en un coup d'œil. Cette boucle de rétroaction immédiate est exactement ce que je recherche dans un framework de développement.
Fonctionnalités principales et flux de travail
BenchLLM est conçu pour évaluer les applications propulsées par LLM en vous permettant de créer des suites de tests, de générer des prédictions et de les évaluer automatiquement. Le flux de travail principal repose sur trois classes principales : Test, Tester et SemanticEvaluator. Vous définissez des objets Test avec une chaîne d'entrée et une liste de sorties attendues (permettant plusieurs réponses correctes). Ensuite, vous instanciez un Tester en passant votre fonction agent (n'importe quel appelable qui renvoie une chaîne), vous ajoutez des tests, et vous l'exécutez pour obtenir des prédictions. Enfin, vous chargez ces prédictions dans un SemanticEvaluator, qui utilise un modèle de langage (comme GPT-3) pour juger si la sortie correspond aux résultats attendus. Cette approche remplace la simple correspondance de chaînes par une compréhension sémantique, ce qui est crucial pour les sorties LLM qui peuvent varier dans leur formulation.
Le framework prend également en charge des stratégies d'évaluation interactives et personnalisées, bien que le site Web ne montre que la voie sémantique automatisée. Une fonctionnalité notable est l'exécuteur de tests intégré à la CLI qui met en cache les résultats et affiche les échecs avec des tableaux détaillés. L'exemple présenté sur la page d'accueil teste un scénario d'hallucination : poser une question sur les Jeux Olympiques de 2024 avant l'événement, où la réponse attendue est « Je ne sais pas ». La sortie CLI marque clairement l'échec. BenchLLM exploite les agents LangChain par défaut, mais vous pouvez intégrer n'importe quelle fonction. La bibliothèque est construite par des ingénieurs pour des ingénieurs – les extraits de code utilisent le typage Python et des motifs modernes. J'ai également remarqué que le projet a une communauté croissante sur GitHub avec une demande d'étoiles, un bon signe pour un support à long terme.
Tarification et position sur le marché
BenchLLM est entièrement open-source. Les tarifs ne sont pas affichés publiquement sur le site Web car il n'y a pas d'offre payante – il est gratuit sous licence open-source. Cela dit, le site Web ne précise pas de fichier de licence, mais le projet est hébergé sur GitHub (j'ai vérifié qu'il a une licence MIT). Cela rend BenchLLM très accessible pour les développeurs individuels et les startups. Comparé aux solutions d'entreprise comme LangSmith ou Weights & Biases Prompts, BenchLLM offre une expérience plus légère et centrée sur le code, sans tableau de bord cloud. Une autre alternative est DeepEval, également open-source mais axé sur les tests unitaires avec des métriques intégrées. BenchLLM se différencie en se concentrant sur l'évaluation sémantique avec un motif flexible Tester/Evaluator et une CLI qui imite les frameworks de test traditionnels comme pytest.
Positionné comme un outil « par des ingénieurs en IA pour des ingénieurs en IA », BenchLLM est particulièrement adapté aux développeurs qui souhaitent intégrer l'évaluation LLM directement dans leurs pipelines CI/CD. Il n'est pas destiné aux équipes non techniques ou à celles qui recherchent un tableau de bord d'évaluation sans code. L'absence d'interface utilisateur hébergée peut dissuader certains utilisateurs, mais la contrepartie est un contrôle complet. Le projet semble relativement récent – le dépôt GitHub montre un nombre modeste d'étoiles et de contributeurs, ce qui signifie que vous pouvez rencontrer des aspérités ou une documentation manquante. Cependant, les fonctionnalités de base sont suffisamment matures pour une utilisation en production, en particulier pour les petits et moyens projets.
Verdict final
Points forts : BenchLLM propose une API propre et intuitive qui s'intègre parfaitement aux projets Python existants. L'évaluateur sémantique réduit les faux positifs produits par la correspondance exacte. La sortie CLI est excellente pour le débogage. Et le fait d'être open-source signifie zéro coût et une personnalisation totale.
Limites : L'outil est actuellement limité à Python et aux agents LangChain par défaut. L'évaluateur sémantique repose sur un modèle tiers (par exemple, GPT-3), ce qui entraîne des coûts d'utilisation et nécessite une clé API. Il n'y a pas de prise en charge intégrée pour d'autres fournisseurs de LLM comme Anthropic ou Cohere pour l'évaluation, bien que vous puissiez écrire des évaluateurs personnalisés. Le projet est encore jeune, donc le support communautaire et la documentation ne sont pas aussi complets que ceux d'outils plus établis.
Recommandation : Essayez BenchLLM si vous êtes un développeur créant des applications LLM et avez besoin d'un framework d'évaluation léger et scriptable que vous pouvez exécuter localement ou dans votre pipeline CI. Il est particulièrement adapté aux équipes ayant une expertise Python qui souhaitent tester les hallucinations, la factualité ou la conformité aux sorties attendues. Cherchez ailleurs si vous avez besoin d'un tableau de bord sans code, d'un support pour d'autres langages que Python, ou d'une plateforme gérée tout-en-un. Visitez BenchLLM sur https://benchllm.com/ pour l'explorer par vous-même.


Commentaires