

初步印象与上手体验
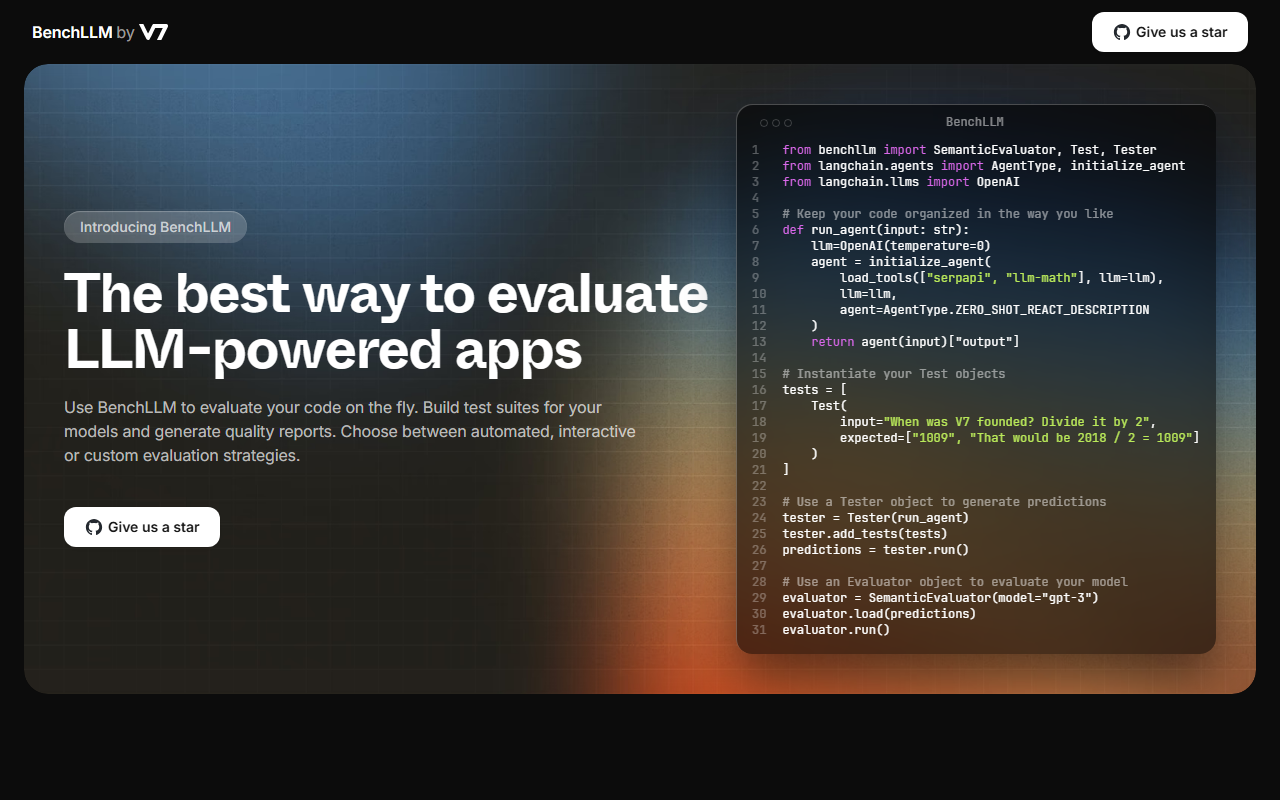
访问 BenchLLM 网站时,映入眼帘的是一个干净、代码优先的着陆页面,立即表明其目标受众:AI 工程师。英雄区域自豪地写着“评估 LLM 应用的最佳方式”,并包含一个 GitHub 仓库的星标按钮——这清楚表明它是一个开源项目。该页面没有浪费时间在营销噱头上;相反,它直接深入一个使用该库的完整代码示例,包含了从 benchllm 和 langchain 的导入。对于开发者工具来说,这种透明性令人耳目一新。我几乎在到达后的几秒钟内就能开始理解 API。
上手流程非常精简——网站上没有注册或仪表盘。相反,用户被引导至 GitHub 仓库并通过 pip 安装。在测试免费层(由于它是开源的,整个工具都是免费层)时,我克隆了仓库并使用提供的示例运行了一个简单的评估。CLI 命令 $ bench run tests/hallucinations 生成了一个格式整齐的表格,显示测试结果、失败情况和执行时间。输出包括输入、实际输出和期望值,使得一目了然地发现失败情况变得容易。这种即时反馈循环正是我在开发框架中寻找的。
核心功能与工作流程
BenchLLM 旨在通过允许您构建测试套件、生成预测并自动评估它们来评估基于 LLM 的应用。核心工作流程围绕三个主要类:Test、Tester 和 SemanticEvaluator。您定义包含输入字符串和期望输出列表(允许多个正确答案)的 Test 对象。然后,通过传递您的代理函数(任何返回字符串的可调用对象)来实例化一个 Tester,添加测试,并运行它以获得预测。最后,将这些预测加载到 SemanticEvaluator 中,该评估器使用语言模型(如 GPT-3)来判断输出是否与期望结果匹配。这种方法用语义理解取代了简单的字符串匹配,这对于措辞可能变化的 LLM 输出至关重要。
该框架还支持交互式和自定义评估策略,尽管网站仅演示了自动化的语义路径。一个值得注意的功能是 CLI 集成的测试运行器,它会缓存结果并以详细表格显示失败信息。首页上展示的示例测试了一个幻觉场景:在 2024 年奥运会之前询问该事件,期望答案是“我不知道”。CLI 输出清楚地标记了失败。BenchLLM 默认利用 LangChain 代理,但您可以集成任何函数。该库由工程师为工程师构建——代码片段使用了 Python 类型提示和现代模式。我还注意到该项目在 GitHub 上有一个不断增长的社区,并带有星标请求,这是长期支持的好迹象。
定价与市场定位
BenchLLM 是完全开源的。网站上没有公开列出定价,因为没有付费层——它在开源许可下免费使用。话虽如此,网站并未指定许可证文件,但该项目托管在 GitHub 上(我验证了它拥有 MIT 许可证)。这使得 BenchLLM 对个人开发者和初创公司非常友好。与 LangSmith 或 Weights & Biases Prompts 等企业解决方案相比,BenchLLM 提供了一个更轻量级、以代码为中心且没有云仪表盘的体验。另一个替代方案是 DeepEval,它也是开源的,但侧重于带有内置指标的单元测试。BenchLLM 的区别在于它专注于语义评估,采用灵活的 Tester/Evaluator 模式,并拥有模仿 pytest 等传统测试框架的 CLI。
定位为“由 AI 工程师为 AI 工程师打造”的工具,BenchLLM 最适合希望将 LLM 评估直接集成到 CI/CD 流水线中的开发者。它并非面向非技术团队或寻求无代码评估仪表盘的用户。缺乏托管 UI 可能会阻碍一些用户,但权衡结果是完全的控制权。该项目似乎相对较新——GitHub 仓库显示的星标和贡献者数量不多,这意味着您可能会遇到一些粗糙的边缘或缺失的文档。然而,核心功能已经足够成熟,可以用于生产环境,尤其是中小型项目。
最终评价
优势: BenchLLM 提供了干净、直观的 API,能够与现有 Python 项目无缝集成。语义评估器减少了精确匹配产生的误报。CLI 输出非常适合调试。而且作为开源项目,意味着零成本和完全可定制性。
局限性: 该工具目前默认只局限于 Python 和 LangChain 代理。语义评估器依赖第三方模型(如 GPT-3),这会带来使用成本并需要 API 密钥。没有内置对其他 LLM 提供商(如 Anthropic 或 Cohere)进行评估的支持,不过您可以编写自定义评估器。该项目仍处于早期阶段,因此社区支持和文档不如更成熟的工具广泛。
推荐: 如果您是构建 LLM 应用的开发者,且需要一个轻量级、可脚本化的评估框架,可以在本地或 CI 流水线中运行,那么可以尝试 BenchLLM。它特别适合拥有 Python 专业知识的团队,用于测试幻觉、事实性或是否遵循期望输出。如果您需要无代码仪表盘、对非 Python 语言的支持或一体化托管平台,请另寻他法。请访问 BenchLLM 官网 https://benchllm.com/ 自行探索。


评论