

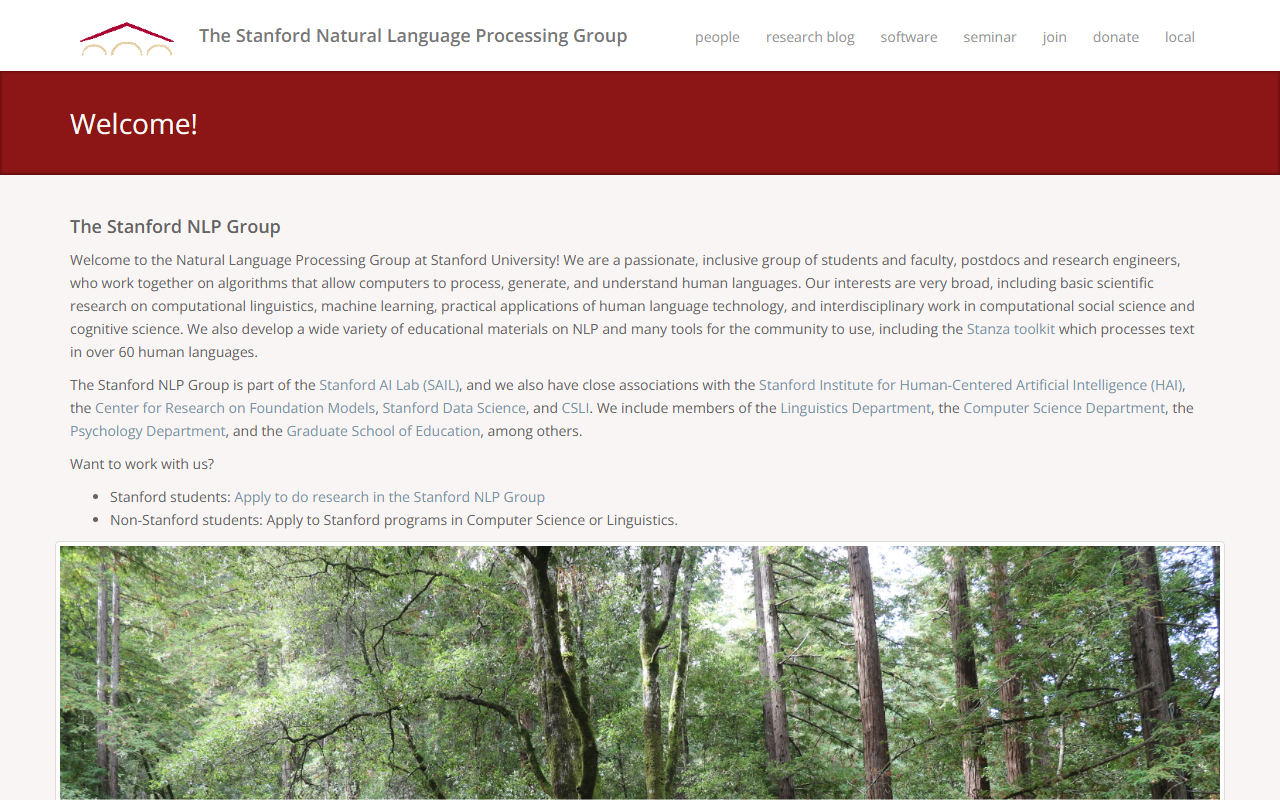
첫인상: Stanford NLP Group이 제공하는 것
Stanford NLP Group의 웹사이트(nlp.stanford.edu)를 방문했을 때, 깔끔한 학술 랜딩 페이지를 볼 수 있었습니다. 이 사이트는 주로 연구, 교육 자료, 소프트웨어 배포를 위한 포털 역할을 합니다. 상용 AI 도구 대시보드와 달리, 가입 양식이나 API 키 생성이 없습니다. 대신 NLP 커뮤니티를 위한 오픈소스 리소스에 중점을 둡니다. 가장 눈에 띄는 도구는 Stanza로, 토큰화, 품사 태깅, 의존 구문 분석, 개체명 인식을 포함하여 60개 이상의 언어로 텍스트를 처리하는 신경망 파이프라인입니다. 그룹은 또한 Java 기반 제품군인 CoreNLP와 점점 늘어나는 교육 리소스를 유지 관리합니다. 개발자와 연구자에게 이곳은 검증된 알고리즘의 보고입니다.
도구 테스트: Stanza 실제 사용
무료 티어(여기서 모든 것은 무료입니다)를 테스트하면서 Stanza의 Python 라이브러리를 살펴보았습니다. pip로 설치하고 샘플 문장 'Stanford University is located in California.'에 대해 파이프라인을 실행했습니다. 기본 영어 모델은 1초 미만으로 처리했으며, 개체, 구문 종속성, 표제어를 정확하게 식별했습니다. 가장 인상 깊었던 점은 다국어 지원이었습니다. 독일어와 일본어 텍스트로 동일한 파이프라인을 테스트했는데, 더 큰 모델을 로딩하는 데 시간이 조금 더 걸렸지만 정확도는 여전히 높았습니다. 사이트의 문서는 설치 및 사용법을 안내하지만, Python과 명령줄 도구에 익숙하다고 가정합니다. 대화형 테스트를 위한 웹 기반 GUI는 없어서 캐주얼한 탐색에는 제한적이지만, 개발자 중심 설계와 일치합니다.
기술 세부 사항 및 통합
Stanford NLP Group의 도구는 신경망과 트랜스포머 아키텍처를 기반으로 구축되었으며, Stanza는 BiLSTM 및 CNN 기반 모델을 사용합니다. 소프트웨어는 Apache 2.0 라이선스 하에 완전히 오픈소스입니다. spaCy나 Hugging Face의 Transformers와 같은 상용 대안과 달리, 관리형 클라우드 API나 유료 지원 티어가 없습니다. 연구자와 엔지니어는 자체 인프라에 모델을 직접 호스팅해야 합니다. 이 도구는 Python, Java(CoreNLP)와 잘 통합되며, 다양한 언어에 대한 사전 훈련된 모델을 포함합니다. 또한 그룹은 생의학 텍스트와 같은 특정 도메인용 사전 패키지 모델을 제공하고, 자체 프레임워크를 사용하여 사용자 정의 모델을 훈련하기 위한 API를 제공합니다. 다국어 NLP 시스템을 구축하는 모든 개발자에게 이는 견고한 기반입니다. 단, 대형 모델을 로컬에서 실행할 수 있는 하드웨어가 필요합니다.
결론 및 권장 사항
Stanford NLP Group이 제공하는 것의 진정한 강점은 무료, 광범위한 언어 지원, 엄격한 학술적 뒷받침입니다. 모델은 잘 문서화되어 있으며 연구 및 프로덕션 환경에서 입증된 신뢰성을 가지고 있습니다. 그러나 실제 한계도 있습니다. 클라우드 호스팅 API가 없고, 학술 포럼 이외의 커뮤니티 지원이 제한적이며, 비개발자에게는 학습 곡선이 가파릅니다. 이 도구는 NLP 연구자, 데이터 과학자, 엔지니어에게 가장 적합합니다. 이들은 무료 고품질 다국어 파이프라인이 필요하고 배포를 직접 처리할 의향이 있는 사람들입니다. 통합이 쉬운 클라우드 API와 관리형 인프라를 선호한다면 Google Cloud Natural Language 또는 AWS Comprehend와 같은 대안을 고려하세요. 그러나 학술적 투명성을 중요시하고 최첨단 NLP 모델을 자체 서버에서 실행하고 싶다면 Stanford NLP Group이 훌륭한 선택입니다. 직접 확인하려면 Stanford NLP Group 웹사이트(https://nlp.stanford.edu/)를 방문하세요.

댓글