

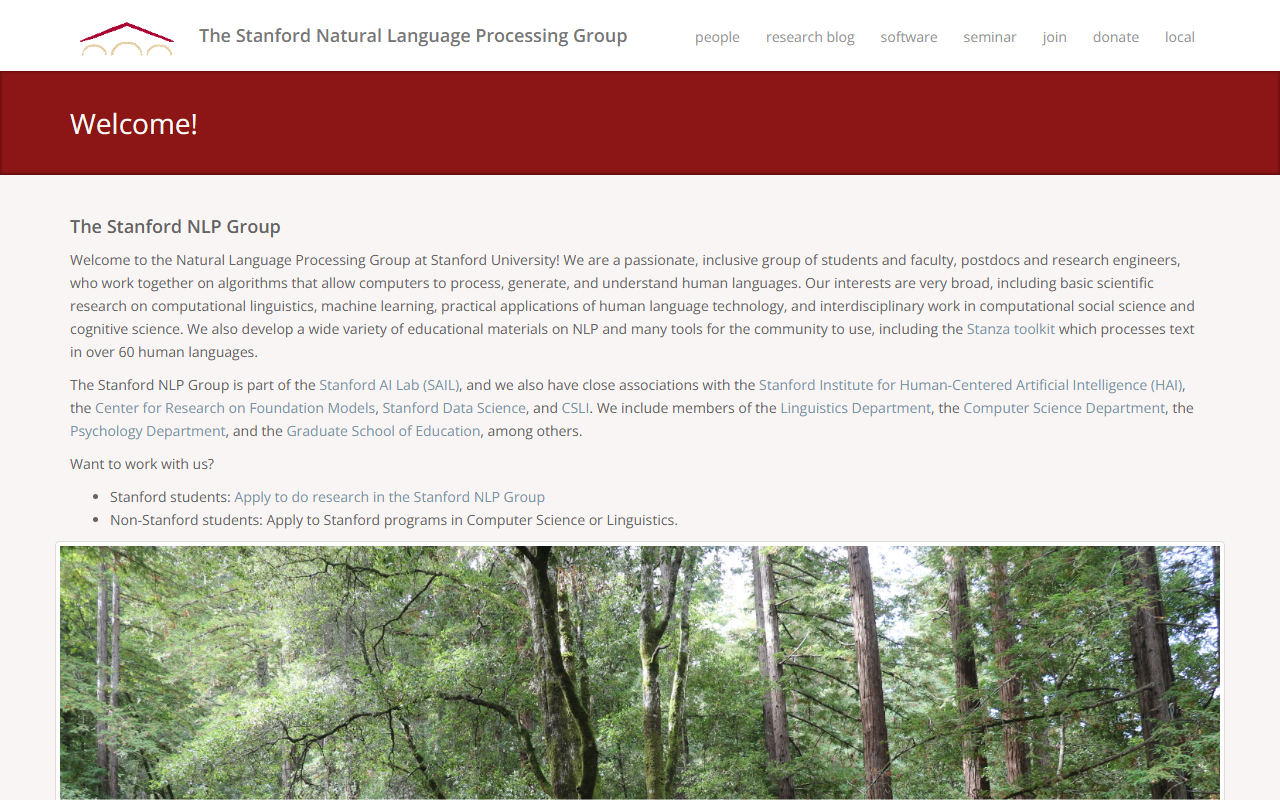
第一印象:スタンフォードNLPグループが提供するもの
スタンフォードNLPグループのウェブサイト(nlp.stanford.edu)を訪れると、清潔感のある学術的なランディングページが表示されます。このサイトは主に、同グループの研究、教育資料、ソフトウェアリリースへのポータルとして機能しています。商用のAIツールのダッシュボードとは異なり、サインアップフォームやAPIキーの生成はありません。代わりに、NLPコミュニティ向けのオープンソースリソースに焦点が当てられています。最も注目されているツールはStanzaで、トークン化、品詞タグ付け、依存関係解析、固有表現認識をカバーし、60以上の言語を処理するニューラルパイプラインです。同グループはJavaベースのスイートであるCoreNLPや、増え続ける教育リソースも維持しています。開発者や研究者にとって、これは実証済みのアルゴリズムの宝庫です。
ツールのテスト:Stanzaを実際に使ってみる
無料ティア(ここにあるものはすべて無料です)をテストするにあたり、StanzaのPythonライブラリを試しました。pipでインストールし、サンプル文「Stanford University is located in California.」でパイプラインを実行しました。デフォルトの英語モデルは1秒未満で処理し、エンティティ、構文依存関係、レンマを正確に識別しました。最も感銘を受けたのは多言語対応です。同じパイプラインをドイツ語と日本語のテキストでテストしましたが、大きなモデルの読み込みに少し時間がかかるものの、精度は高いままでした。サイトのドキュメントではインストールと使い方を案内していますが、Pythonとコマンドラインツールに慣れていることを前提としています。インタラクティブなテスト用のWebベースGUIはなく、カジュアルな探索は制限されますが、開発者向けの設計に沿っています。
技術詳細と統合
スタンフォードNLPグループのツールは、ニューラルネットワークとトランスフォーマーアーキテクチャを基盤としており、StanzaはBiLSTMとCNNベースのモデルを使用しています。このソフトウェアはApache 2.0ライセンスのもとで完全にオープンソースです。spaCyやHugging FaceのTransformersのような商用の代替品とは異なり、管理されたクラウドAPIや有料サポートティアはありません。研究者やエンジニアは、自身のインフラ上でモデルを自己ホストする必要があります。これらのツールはPython、Java(CoreNLP)との統合が良好で、多様な言語の事前学習済みモデルを含んでいます。また、バイオメディカルテキストなどの特定ドメイン向けのモデルも提供しており、フレームワークを使用してカスタムモデルをトレーニングするためのAPIも用意されています。多言語NLPシステムを構築する開発者にとって、大規模なモデルをローカルで実行できるハードウェアがあれば、これは堅固な基盤となります。
結論と推奨事項
スタンフォードNLPグループの提供内容の真の強みは、無料であること、幅広い言語カバレッジ、厳格な学術的裏付けです。モデルは十分に文書化されており、研究や本番環境での信頼性が実証されています。ただし、現実的な制限もあります。クラウドホスト型のAPIがないこと、学術フォーラム以外でのコミュニティサポートが最小限であること、非開発者にとって学習曲線が急であることです。このツールは、無料で高品質な多言語パイプラインを必要とし、デプロイメントを自分で行う意思があるNLP研究者、データサイエンティスト、エンジニアに最も適しています。管理されたインフラを持つ簡単に統合できるクラウドAPIを好む場合は、Google Cloud Natural LanguageやAWS Comprehendなどの代替案を検討してください。しかし、学術的な透明性を重視し、自社のサーバーで最先端のNLPモデルを実行したいのであれば、スタンフォードNLPグループは優れた選択肢です。スタンフォードNLPグループのウェブサイト(https://nlp.stanford.edu/)にアクセスして、実際に試してみてください。


コメント