

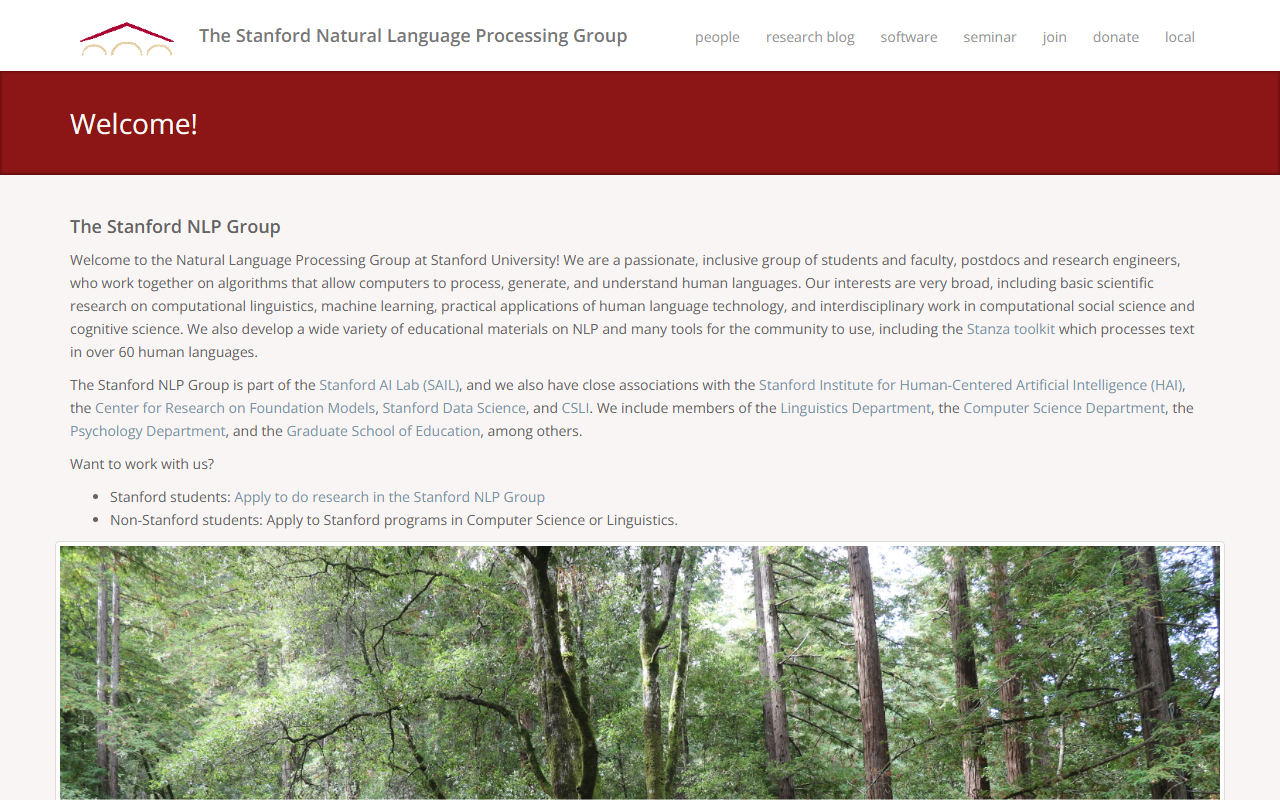
Premières impressions : ce que propose le Stanford NLP Group
En visitant le site web du Stanford NLP Group à l’adresse nlp.stanford.edu, j’ai été accueilli par une page d’accueil académique sobre. Le site sert avant tout de portail pour les travaux de recherche, les supports pédagogiques et les versions logicielles du groupe. Contrairement aux tableaux de bord des outils d’IA commerciaux, il n’y a ni formulaire d’inscription ni génération de clé API. L’accent est plutôt mis sur les ressources open source destinées à la communauté du NLP. L’outil le plus mis en avant est Stanza, un pipeline neuronal qui traite du texte dans plus de 60 langues, couvrant la tokenisation, l’étiquetage morphosyntaxique, l’analyse syntaxique par dépendances et la reconnaissance d’entités nommées. Le groupe propose également CoreNLP, une suite basée sur Java, ainsi qu’une collection croissante de ressources pédagogiques. Pour les développeurs et les chercheurs, c’est une mine d’algorithmes éprouvés.
Test des outils : Stanza en action
En testant le niveau gratuit – et ici tout est gratuit –, je me suis plongé dans la bibliothèque Python de Stanza. Je l’ai installée via pip et j’ai exécuté le pipeline sur une phrase exemple : « Stanford University is located in California. » Le modèle anglais par défaut l’a traitée en moins d’une seconde, identifiant avec précision les entités, les dépendances syntaxiques et les lemmes. Ce qui m’a le plus impressionné, c’est le support multilingue. J’ai testé le même pipeline sur des textes en allemand et en japonais, et bien que le chargement des modèles plus volumineux ait pris un peu plus de temps, la précision est restée élevée. La documentation du site vous guide à travers l’installation et l’utilisation, même si elle suppose que vous êtes à l’aise avec Python et les outils en ligne de commande. Il n’existe pas d’interface graphique web pour des tests interactifs, ce qui limite l’exploration occasionnelle mais reste cohérent avec une conception destinée aux développeurs.
Détails techniques et intégration
Les outils du Stanford NLP Group reposent sur des réseaux de neurones et des architectures transformeurs, Stanza utilisant un modèle basé sur BiLSTM et CNN. Le logiciel est entièrement open source sous licence Apache 2.0. Contrairement aux alternatives commerciales comme spaCy ou Hugging Face Transformers, il n’y a pas d’API cloud gérée ni d’offre de support payant. Les chercheurs et les ingénieurs doivent héberger eux-mêmes les modèles sur leur propre infrastructure. Les outils s’intègrent bien avec Python, Java (CoreNLP) et incluent des modèles pré-entraînés pour un large éventail de langues. Le groupe fournit également des modèles pré-packagés pour des domaines spécifiques, comme le texte biomédical, et propose des API pour entraîner des modèles personnalisés à l’aide de leur framework. Pour tout développeur construisant des systèmes de NLP multilingues, il s’agit d’une base solide – à condition de disposer du matériel nécessaire pour exécuter les grands modèles localement.
Conclusion et recommandations
Les véritables atouts des offres du Stanford NLP Group incluent le coût zéro, une large couverture linguistique et un solide ancrage académique. Les modèles sont bien documentés et ont prouvé leur fiabilité dans des contextes de recherche et de production. Cependant, il existe des limites réelles : pas d’API hébergée dans le cloud, un support communautaire minimal en dehors des forums académiques, et une courbe d’apprentissage abrupte pour les non-développeurs. L’outil est surtout adapté aux chercheurs en NLP, aux data scientists et aux ingénieurs qui ont besoin d’un pipeline multilingue gratuit et de haute qualité, et qui sont prêts à gérer eux-mêmes le déploiement. Si vous préférez des API cloud faciles à intégrer avec une infrastructure gérée, envisagez des alternatives comme Google Cloud Natural Language ou AWS Comprehend. Mais si la transparence académique vous importe et que vous souhaitez exécuter des modèles de NLP de pointe sur vos propres serveurs, le Stanford NLP Group est un excellent choix. Visitez le Stanford NLP Group à l’adresse https://nlp.stanford.edu/ pour l’explorer par vous-même.

Commentaires