

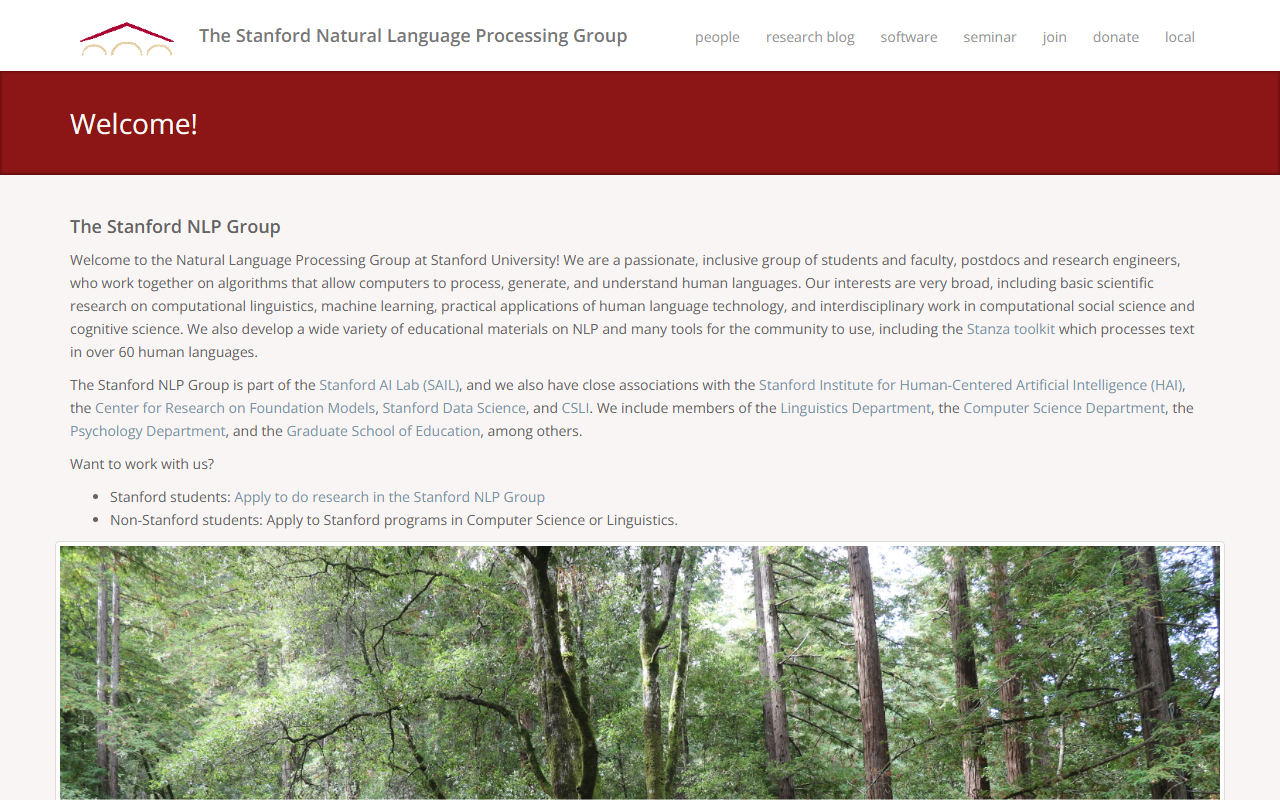
第一印象:斯坦福NLP小组提供什么
访问斯坦福NLP小组网站(nlp.stanford.edu),映入眼帘的是一个简洁的学术主页。该网站主要作为小组研究、教学材料和软件发布的入口。与商业AI工具面板不同,这里没有注册表单或API密钥生成,而是聚焦于面向NLP社区的开源资源。最突出的工具是Stanza,一种神经管道,支持60多种语言的文本处理,涵盖分词、词性标注、依存句法分析和命名实体识别。该小组还维护着CoreNLP(基于Java的套件)以及不断增长的教学资源。对于开发者和研究人员而言,这里是经过实战检验的算法宝库。
工具测试:Stanza实战
在测试免费层(这里所有工具完全免费)时,我深入体验了Stanza的Python库。通过pip安装后,我用例句“Stanford University is located in California.”运行管道。默认英文模型在不到一秒内完成处理,准确识别实体、句法依存和词元。最令我印象深刻的是多语言支持。我用德语和日语文本测试了同一管道,虽然加载较大模型稍慢,但准确性依然很高。网站上的文档指导安装和使用,但要求你熟悉Python和命令行工具。没有基于Web的GUI供交互式测试,这限制了随意探索,但符合开发者导向的设计。
技术细节与集成
斯坦福NLP小组的工具基于神经网络和transformer架构构建,Stanza采用BiLSTM和CNN基础模型。软件完全开源,基于Apache 2.0许可证。与spaCy或Hugging Face's Transformers等商业替代品不同,这里没有托管的云API或付费支持层。研究人员和工程师需在自己基础设施上自托管模型。这些工具与Python、Java(CoreNLP)良好集成,并提供多种语言的预训练模型。小组还提供特定领域(如生物医学文本)的预打包模型,并支持使用其框架训练自定义模型的API。对于任何构建多语言NLP系统的开发者而言,这是一个坚实的基础——前提是你有足够的硬件在本地运行大型模型。
结论与建议
斯坦福NLP小组产品的真正优势包括:零成本、广泛的语言覆盖和严格的学术背景。模型文档完善,在研究和生产环境中证明可靠。但存在实际限制:无云托管API、学术论坛以外的社区支持极少、对非开发者学习曲线陡峭。该工具最适合NLP研究人员、数据科学家和工程师,他们需要一个免费高质量的多语言管道,并愿意自行处理部署。如果你更倾向于易于集成且基础设施托管的云API,可考虑Google Cloud Natural Language或AWS Comprehend等替代方案。但如果你重视学术透明度,并希望在自己服务器上运行最先进的NLP模型,斯坦福NLP小组是绝佳选择。请访问斯坦福NLP小组 https://nlp.stanford.edu/ 自行探索。


评论