
첫인상 및 온보딩
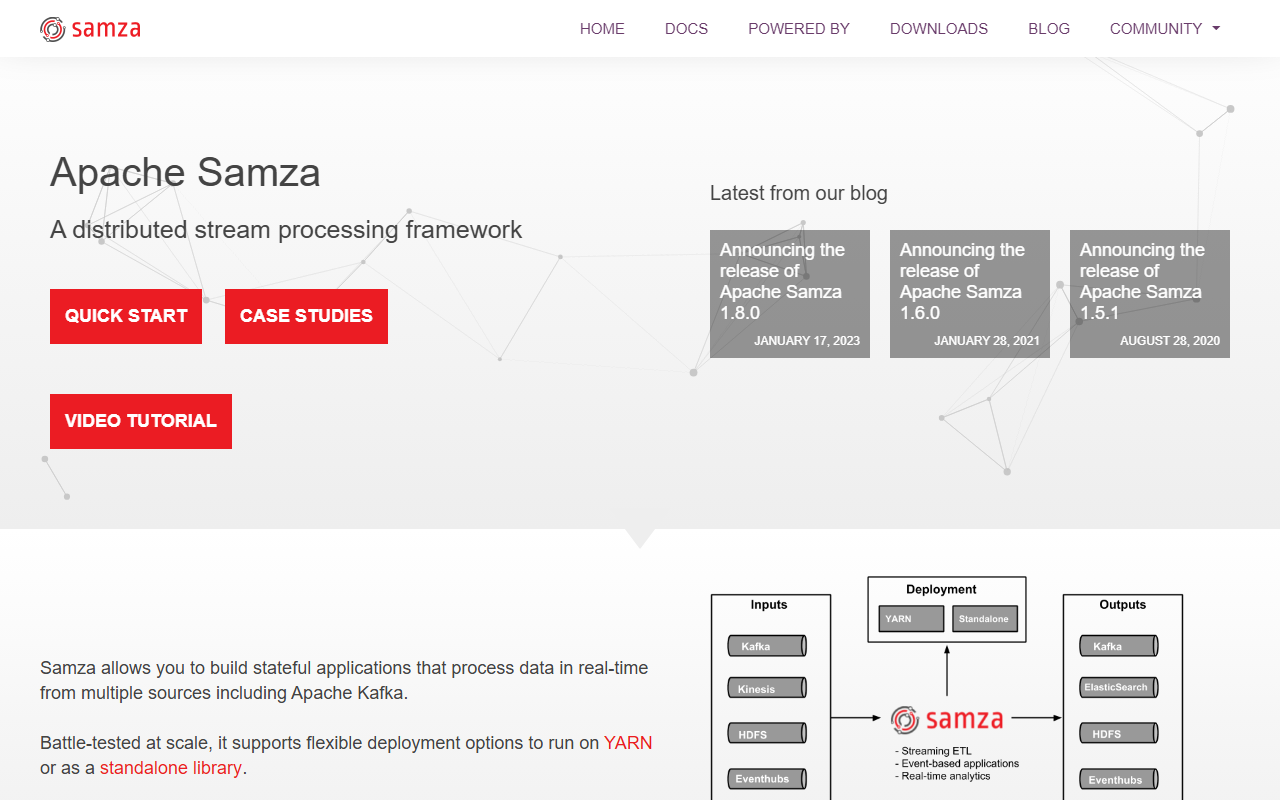
Apache Samza 웹사이트(samza.apache.org)를 방문했을 때, 깔끔하고 문서 중심의 인터페이스가 인상적이었습니다. 랜딩 페이지에는 프레임워크의 핵심 약속인 'Apache Kafka를 포함한 여러 소스에서 실시간으로 데이터를 처리하는 상태 저장 애플리케이션 구축'이 즉시 강조되어 있습니다. 눈에 띄는 '빠른 시작(Quick Start)' 버튼이 있어 클릭하여 바로 시작했습니다. 빠른 시작 가이드는 간단한 단어 개수 예제를 사용하여 로컬 Samza 작업을 설정하는 방법을 안내합니다. 이는 스트림 처리의 '헬로 월드'라고 할 수 있습니다. 저는 저장소를 클론하고, Gradle 빌드를 실행하고, Kafka 토픽에서 데이터를 소비하고 결과를 다른 토픽에 쓰는 독립형 Samza 애플리케이션을 실행하는 단계를 따랐습니다. 전체 과정은 약 15분이 걸렸지만, Java, Maven/Gradle 및 실행 중인 Kafka 인스턴스가 이미 있다고 가정합니다. 새로운 사용자에게는 샌드박스나 호스팅된 평가판이 없다는 것이 인프라를 직접 설정해야 한다는 의미입니다. 이는 Confluent Cloud와 같은 관리형 서비스에 비해 상당한 장벽입니다.
핵심 기술 및 아키텍처
Apache Samza는 원래 LinkedIn에서 개발되었으며 현재 Apache 최상위 프로젝트인 분산 스트림 처리 프레임워크입니다. 고처리량, 저지연, 상태 저장 스트림 처리를 위해 설계되었습니다. 기본 엔진은 플러그 가능한 아키텍처를 사용하며, 기본 메시징 계층으로 Apache Kafka와 통합되지만 HDFS, AWS Kinesis, Azure Event Hubs, 키-값 저장소 및 ElasticSearch도 지원합니다. Samza는 YARN, Kubernetes 또는 독립형 라이브러리로 실행됩니다. 이러한 유연성은 이미 이러한 오케스트레이터를 사용하는 조직에 매력적입니다. 프레임워크는 여러 API 계층을 제공합니다. 세밀한 제어를 위한 저수준 API, 일반적인 작업을 위한 Streams DSL, SQL 유사 쿼리를 위한 Samza SQL, 이식성을 위한 Apache Beam 러너가 있습니다. 테스트 중에 Streams DSL이 간단한 파이프라인을 구축하는 데 직관적이라는 것을 알았지만, 문서에서는 고급 상태 관리를 위해서는 저수준 API를 사용해야 한다고 경고합니다. Samza는 증분 체크포인팅과 호스트 선호도를 사용하여 상태를 테라바이트 규모로 확장합니다. 웹사이트에 따르면 이는 대규모로 실전 검증되었습니다(예: LinkedIn은 매일 수십억 개의 메시지를 처리합니다).
가격 및 시장 포지셔닝
Apache Samza는 Apache 2.0 라이선스 하에 완전히 무료이며 오픈 소스입니다. 유료 티어나 엔터프라이즈 에디션은 없으며 커뮤니티 주도 프로젝트입니다. 가격은 오픈 소스라는 점 외에 웹사이트에 공개적으로 나와 있지 않지만, 자체 클러스터를 운영하는 데 인프라 비용이 발생합니다. 경쟁이 치열한 스트림 처리 환경에서 Samza는 Apache Flink 및 Kafka Streams와 직접 경쟁합니다. 이벤트 시간 처리와 더 풍부한 SQL 계층을 강조하는 Flink와 달리, Samza는 긴밀한 Kafka 통합과 플러그 가능한 배포에서 강점을 보입니다. Kafka Streams는 더 가볍고 임베드하기 쉽지만, Samza는 별도의 처리 컨테이너를 통해 더 강력한 상태 관리와 격리를 제공합니다. Samza는 이미 Hadoop 생태계(YARN)에 투자한 팀이나 결정적 상태로 대규모 스트림을 처리해야 하는 팀에 가장 적합합니다. 소규모 프로젝트나 강력한 Java/Scala 전문 지식이 없는 팀에게는 덜 이상적입니다.
강점, 한계 및 최종 평가
강점: Apache Samza는 LinkedIn 및 기타 주요 기업에서 실전 검증된 성숙한 프레임워크입니다. 저지연, 고처리량 기능은 잘 문서화되어 있습니다. 플러그 가능한 아키텍처 덕분에 처리 로직을 다시 작성하지 않고도 기본 스토리지 및 메시징 시스템을 교체할 수 있습니다. 여러 API(DSL, SQL, Beam)를 지원하여 다양한 개발자 선호도에 유연성을 제공합니다. YARN 또는 Kubernetes에 배포하는 것은 현대적인 인프라 관행과 일치합니다. 커뮤니티 활동은 적당하며, 최신 안정 버전(1.8.0)은 2023년 1월에 출시되었고 블로그에는 지속적인 업데이트가 표시됩니다.
한계: 가장 큰 단점은 가파른 학습 곡선입니다. 프레임워크는 분산 시스템, Java 및 스트림 처리 개념에 대한 친숙함을 가정합니다. 문서는 철저하지만 밀도가 높을 수 있으며 빠른 시작 외에는 초보자 친화적인 튜토리얼이 부족합니다. 설정 없이 테스트할 수 있는 클라우드 호스팅 샌드박스가 없습니다. Flink와 비교할 때 Samza의 SQL 지원은 덜 정교하며, 언어 간 API 일관성은 JVM 언어로 제한됩니다. 또한 모니터링 및 디버깅 생태계는 관리형 서비스만큼 풍부하지 않습니다.
추천: Apache Samza는 프로덕션 환경에서 안정적이고 고성능의 스트림 처리 프레임워크가 필요한 엔지니어링 팀, 특히 이미 Kafka와 YARN/Kubernetes를 실행 중인 팀에게 추천합니다. 또한 테라바이트 규모의 증분 체크포인팅이 필요한 상태 저장 애플리케이션에 강력한 선택입니다. 독립 개발자나 소규모 팀이 빠른 프로토타이핑을 원한다면 더 쉬운 온보딩을 위해 Apache Flink 또는 Kafka Streams를 고려하세요. 전반적으로 Samza는 진지한 스트림 처리 워크로드를 위한 견고한 오픈 소스 작업 도구입니다.
Apache Samza를 직접 살펴보려면 https://samza.apache.org/를 방문하세요.










댓글