
第一印象与上手体验
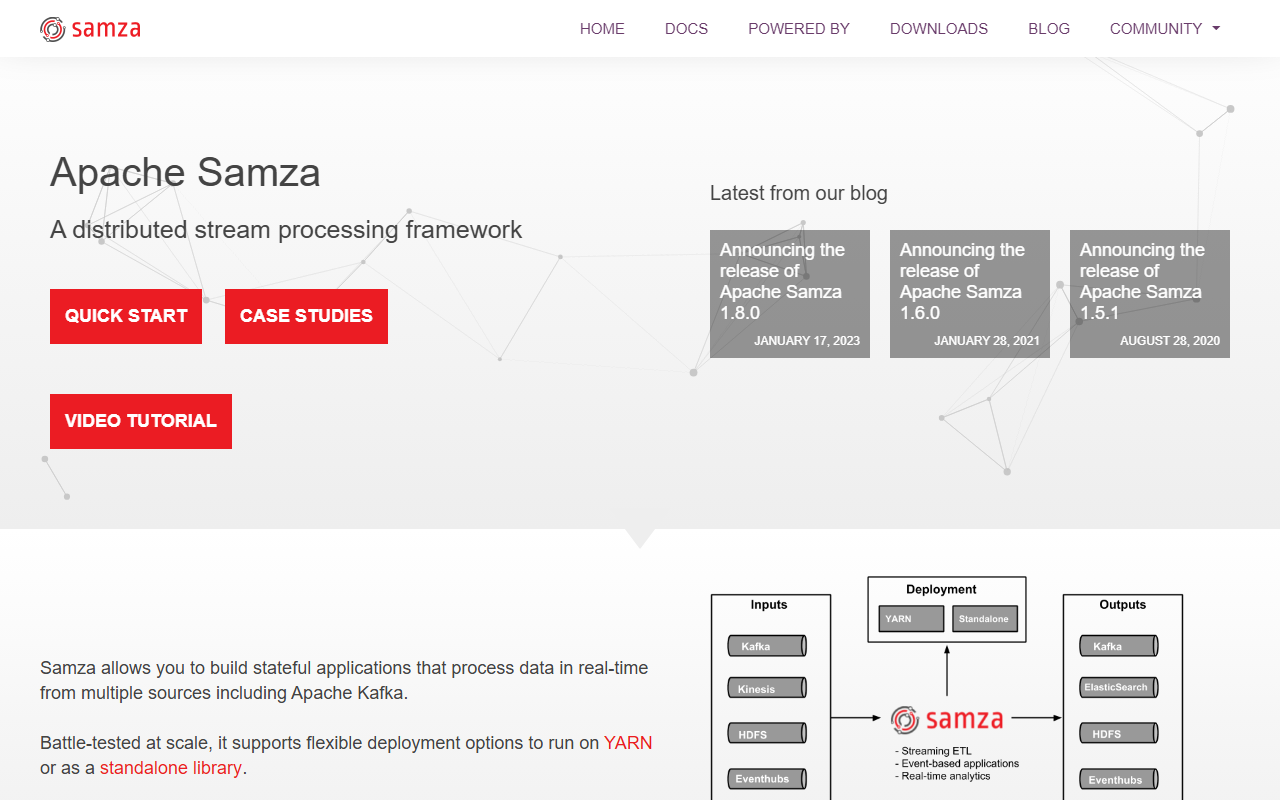
打开 samza.apache.org 上的 Apache Samza 网站,迎接我的是简洁、以文档为主的界面。着陆页立即突出了该框架的核心承诺:构建从多个来源(包括 Apache Kafka)实时处理数据的有状态应用。页面上有一个醒目的“快速开始”按钮,我点击后开始深入了解。快速开始指南通过一个简单的单词计数示例(基本上是流处理的“Hello World”)引导你设置本地 Samza 任务。我按照步骤操作:克隆仓库、运行 Gradle 构建、启动一个从 Kafka 主题消费并将结果写入另一个主题的独立 Samza 应用程序。整个过程大约耗时 15 分钟,但前提是你已经安装了 Java、Maven/Gradle 并运行了 Kafka 实例。对于新手来说,缺乏沙盒或托管试用环境意味着必须自行搭建基础设施——与 Confluent Cloud 等托管服务相比,这是一个明显的障碍。
核心技术架构
Apache Samza 是一个分布式流处理框架,最初由 LinkedIn 开发,现已成为 Apache 顶级项目。它专为高吞吐量、低延迟、有状态的流处理而设计。底层引擎采用可插拔架构,以 Apache Kafka 为主要消息层,但也支持 HDFS、AWS Kinesis、Azure Event Hubs、键值存储和 ElasticSearch。Samza 可运行在 YARN、Kubernetes 或作为独立库——这种灵活性使其对已在使用这些编排器的组织具有吸引力。该框架提供多个 API 层:用于精细控制的低级 API、用于常见操作的 Streams DSL、用于 SQL 风格查询的 Samza SQL,以及用于可移植性的 Apache Beam 运行器。在测试中,我发现 Streams DSL 对于构建简单管道非常直观,但文档警告说,高级状态管理需要深入低级 API。Samza 使用增量检查点和主机亲和性将状态扩展到 TB 级别,网站声称这已在规模上经过实战考验(例如,LinkedIn 每天处理数十亿条消息)。
定价与市场定位
Apache Samza 完全免费且开源,采用 Apache 2.0 许可。没有付费层级或企业版——它是一个社区驱动的项目。网站上没有公开列出定价(除了开源这一点),但你需要承担运行自有集群的基础设施成本。在竞争激烈的流处理领域,Samza 直接与 Apache Flink 和 Kafka Streams 竞争。与强调事件时间处理和更丰富 SQL 层的 Flink 不同,Samza 的优势在于其紧密的 Kafka 集成和可插拔部署。Kafka Streams 更轻量且易于嵌入,但 Samza 通过独立的处理容器提供了更强大的状态管理和隔离。Samza 最适合那些已经投资 Hadoop 生态系统(YARN)的团队,或者需要处理具有确定性状态的海量流的团队。对于小型项目或缺乏深厚 Java/Scala 专业知识的团队来说,它不太理想。
优势、局限与最终评价
优势: Apache Samza 成熟可靠,已在 LinkedIn 及其他大型企业中经过实战检验。其低延迟、高吞吐量的能力有据可查。可插拔架构意味着你可以更换底层存储和消息系统,而无需重写处理逻辑。支持多种 API(DSL、SQL、Beam)为不同开发人员偏好提供了灵活性。在 YARN 或 Kubernetes 上部署符合现代基础设施实践。社区活动适中——最新稳定版(1.8.0)于 2023 年 1 月发布,博客显示持续更新。
局限: 陡峭的学习曲线是最大的缺点。该框架假设用户熟悉分布式系统、Java 和流处理概念。文档虽然详尽,但可能过于密集,除了快速开始之外缺乏适合初学者的教程。没有云托管沙盒可供无需设置即可测试。与 Flink 相比,Samza 的 SQL 支持不够成熟,并且跨语言的 API 一致性仅限于 JVM 语言。此外,监控和调试方面的生态系统不如托管服务丰富。
推荐建议: 我会向需要可靠、高性能流处理框架用于生产环境的工程团队推荐 Apache Samza,特别是如果他们已经在运行 Kafka 和 YARN/Kubernetes。对于需要 TB 级增量检查点的有状态应用,它也是一个强有力的选择。如果你是独立开发者或小团队,希望快速原型开发,可以考虑 Apache Flink 或 Kafka Streams,因为它们上手更轻松。总的来说,Samza 是一款可靠的开源利器,适用于严肃的流处理工作负载。
请访问 Apache Samza 官网 https://samza.apache.org/ 自行探索。










评论