
初印象とオンボーディング
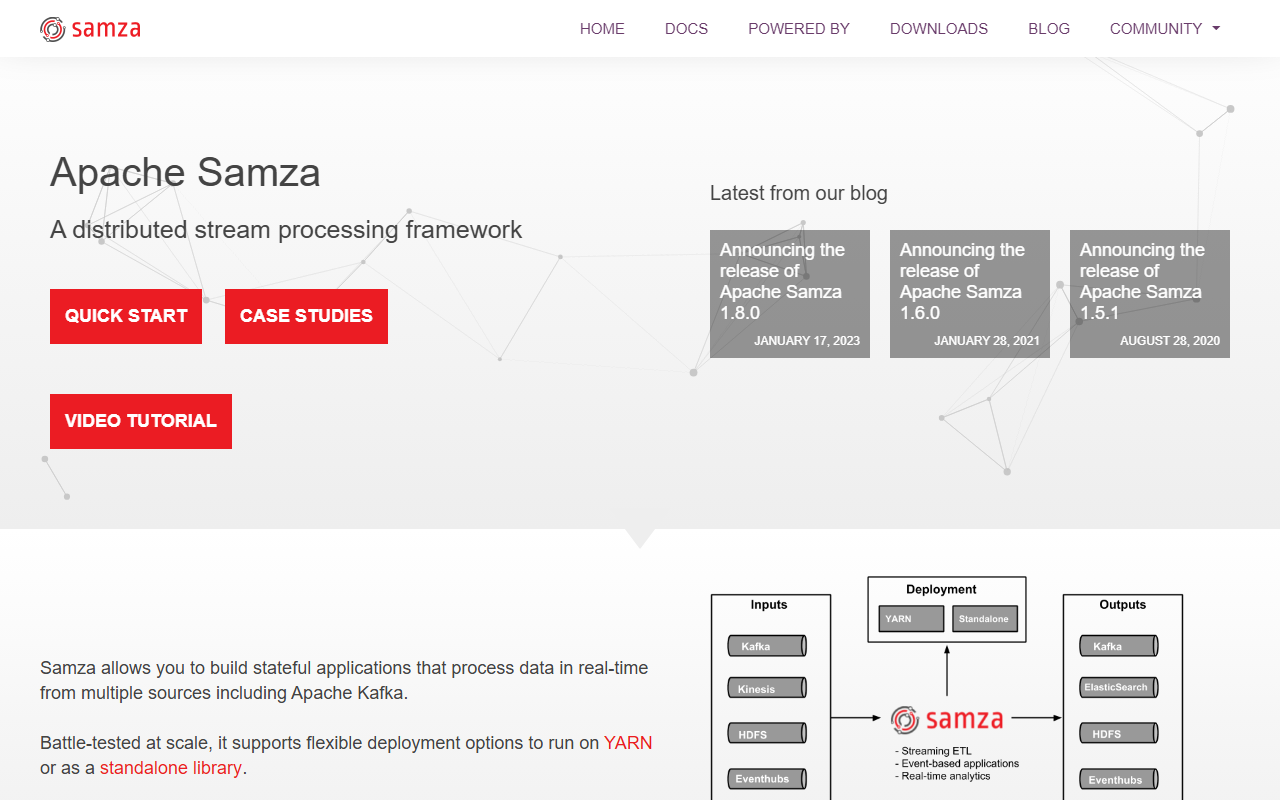
Apache Samza のウェブサイト(samza.apache.org)を訪問すると、ドキュメント重視のすっきりしたインターフェースが表示されました。ランディングページには、複数のソース(Apache Kafka を含む)からリアルタイムでデータを処理するステートフルアプリケーションを構築するという、フレームワークの核となる約束がすぐに強調されています。「Quick Start」ボタンが目立つように配置されており、それをクリックして試してみました。Quick Start ガイドでは、単純なワードカウントの例(ストリーム処理の「Hello World」とも言えるもの)を使って、ローカルの Samza ジョブを設定する手順が説明されています。手順に従って、リポジトリのクローン、Gradle ビルドの実行、Kafka トピックから消費して別のトピックに結果を書き込むスタンドアロンの Samza アプリケーションの起動を行いました。全体のプロセスは約15分で完了しましたが、Java、Maven/Gradle、および動作中の Kafka インスタンスが既にあることを前提としています。初心者にとっては、サンドボックスやホスト型のトライアルがないため、自分でインフラを構築する必要があります。これは、Confluent Cloud のようなマネージドサービスと比較して顕著な障壁です。
コア技術とアーキテクチャ
Apache Samza は、もともと LinkedIn で開発され、現在は Apache トップレベルプロジェクトとなっている分散ストリーム処理フレームワークです。高スループット、低レイテンシ、ステートフルなストリーム処理のために設計されています。基盤となるエンジンはプラグイン可能なアーキテクチャを採用しており、主要なメッセージングレイヤとして Apache Kafka と統合されていますが、HDFS、AWS Kinesis、Azure Event Hubs、キーバリューストア、ElasticSearch もサポートしています。Samza は YARN、Kubernetes、またはスタンドアロンライブラリとして実行可能で、これらのオーケストレーターを既に使用している組織にとって魅力的な柔軟性を提供します。フレームワークは複数の API レイヤを提供しています。細かい制御のための低レベル API、一般的な操作のための Streams DSL、SQL ライクなクエリのための Samza SQL、そして移植性のための Apache Beam ランナーです。テスト中、Streams DSL は単純なパイプラインの構築には直感的だと感じましたが、ドキュメントでは、高度な状態管理には低レベル API への移行が必要であると警告しています。Samza はインクリメンタルチェックポイントとホストアフィニティを使用して、状態をテラバイト規模にスケーリングします。ウェブサイトによると、これは大規模な環境で実戦テスト済みです(例:LinkedIn は日々数十億のメッセージを処理しています)。
料金と市場での位置づけ
Apache Samza は完全に無料で、Apache 2.0 ライセンスの下でオープンソースです。有料のティアやエンタープライズ版はなく、コミュニティ主導のプロジェクトです。料金はオープンソースであること以外にはウェブサイトに明記されていませんが、独自のクラスターを運用するためのインフラコストが発生します。競争の激しいストリーム処理分野において、Samza は直接 Apache Flink や Kafka Streams と競合します。イベント時間処理と豊富な SQL レイヤを強調する Flink とは異なり、Samza は緊密な Kafka 統合とプラグイン可能なデプロイメントで優れています。Kafka Streams はより軽量で組み込みが容易ですが、Samza は個別の処理コンテナによるより堅牢な状態管理と分離を提供します。Samza は、すでに Hadoop エコシステム(YARN)に投資しているチームや、大規模なストリームを決定論的な状態で処理する必要があるチームに最適です。小規模なプロジェクトや、Java/Scala の専門知識が乏しいチームにはあまり適していません。
強み、限界、そして最終評価
強み: Apache Samza は成熟しており、LinkedIn や他の大手企業で実戦テスト済みです。低レイテンシ、高スループットの機能は十分に文書化されています。プラグイン可能なアーキテクチャにより、処理ロジックを書き換えることなく、基盤となるストレージやメッセージングシステムを交換できます。複数の API(DSL、SQL、Beam)のサポートにより、開発者の好みに応じて柔軟性が得られます。YARN または Kubernetes へのデプロイメントは、現代のインフラ慣行に適合しています。コミュニティ活動は適度で、最新の安定版リリース(1.8.0)は2023年1月であり、ブログでは継続的な更新が示されています。
限界: 最も大きな欠点は、学習曲線が急であることです。このフレームワークは、分散システム、Java、ストリーム処理の概念についての知識を前提としています。ドキュメントは詳細ですが、密度が高く、Quick Start 以外の初心者向けチュートリアルが不足しています。セットアップなしでテストできるクラウドホスト型のサンドボックスはありません。Flink と比較すると、Samza の SQL サポートは洗練されておらず、API の言語間の一貫性は JVM 言語に限定されています。さらに、監視とデバッグに関するエコシステムは、マネージドサービスほど充実していません。
推奨: Apache Samza は、特に既に Kafka と YARN/Kubernetes を運用している場合、本番環境で信頼性の高い高性能ストリーム処理フレームワークを必要とするエンジニアリングチームにお勧めします。また、テラバイト規模のインクリメンタルチェックポイントを必要とするステートフルアプリケーションにも強力な選択肢です。単独の開発者や小規模チームで迅速なプロトタイピングを希望する場合は、より穏やかなオンボーディングのために Apache Flink や Kafka Streams を検討してください。全体として、Samza は本格的なストリーム処理ワークロードのための堅実なオープンソースの主力製品です。
Apache Samza の詳細は https://samza.apache.org/ をご覧ください。










コメント