
Premières impressions et prise en main
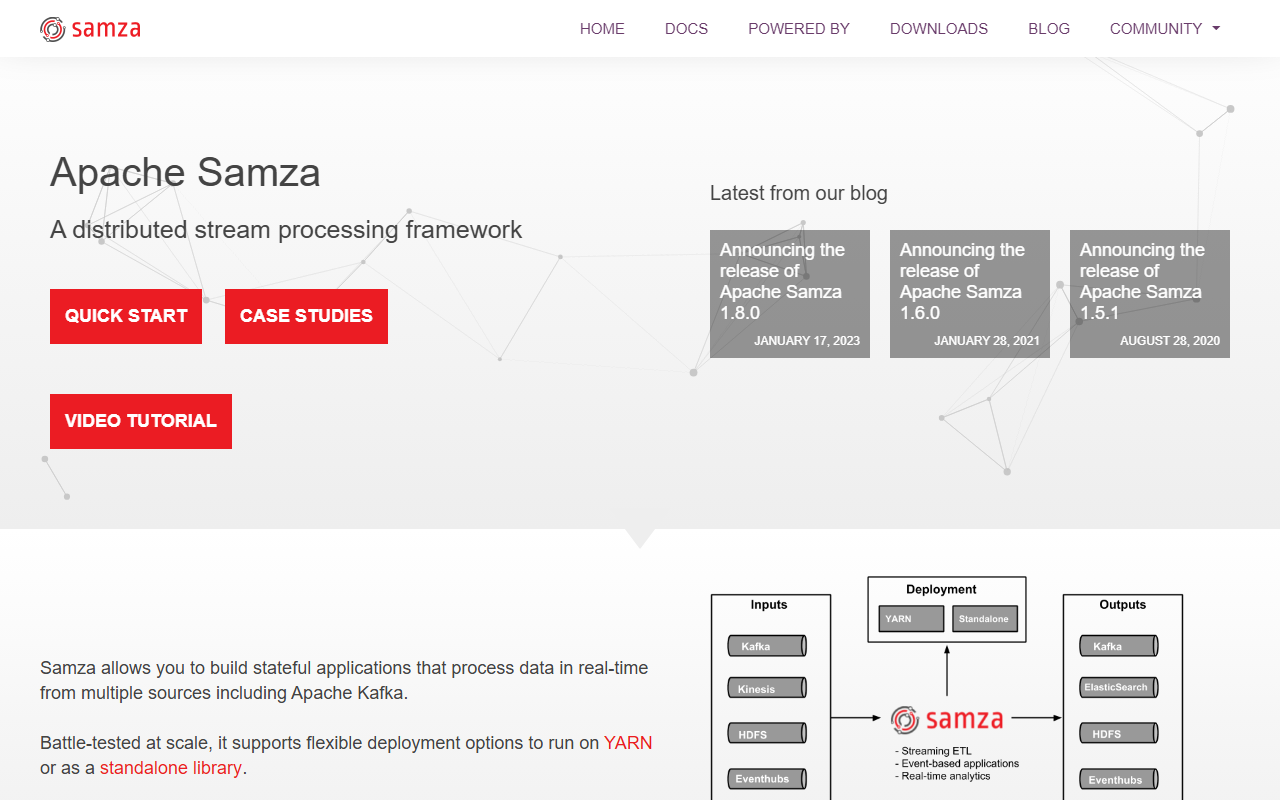
En visitant le site web d'Apache Samza à samza.apache.org, j'ai été accueilli par une interface propre, axée sur la documentation. La page d'accueil met immédiatement en avant la promesse centrale du framework : créer des applications étatiques qui traitent des données en temps réel à partir de multiples sources, y compris Apache Kafka. Il y a un bouton « Quick Start » bien visible, que j'ai cliqué pour commencer. Le guide Quick Start vous guide à travers la configuration d'un job Samza local à l'aide d'un exemple simple de comptage de mots — essentiellement le « Hello World » du traitement de flux. J'ai suivi les étapes : cloner le dépôt, exécuter une construction Gradle et lancer une application Samza autonome qui consomme à partir d'un topic Kafka et écrit les résultats dans un autre. L'ensemble du processus a pris environ 15 minutes, mais il suppose que vous ayez déjà Java, Maven/Gradle et une instance Kafka en cours d'exécution. Pour les nouveaux venus, l'absence de bac à sable ou d'essai hébergé signifie que vous devez configurer vous-même l'infrastructure — un obstacle notable par rapport à des services gérés comme Confluent Cloud.
Technologie de base et architecture
Apache Samza est un framework de traitement de flux distribué développé à l'origine chez LinkedIn et maintenant un projet de premier niveau Apache. Il est conçu pour le traitement étatique de flux à haut débit et faible latence. Le moteur sous-jacent utilise une architecture enfichable qui s'intègre à Apache Kafka en tant que couche de messagerie principale, mais prend également en charge HDFS, AWS Kinesis, Azure Event Hubs, les magasins clé-valeur et ElasticSearch. Samza fonctionne sur YARN, Kubernetes ou comme bibliothèque autonome — une flexibilité qui le rend attractif pour les organisations utilisant déjà ces orchestrateurs. Le framework propose plusieurs couches d'API : une API bas niveau pour un contrôle granulaire, un Streams DSL pour les opérations courantes, Samza SQL pour des requêtes de type SQL et un exécuteur Apache Beam pour la portabilité. Lors des tests, j'ai trouvé le Streams DSL intuitif pour construire des pipelines simples, mais la documentation prévient que la gestion avancée de l'état nécessite de plonger dans l'API bas niveau. Samza utilise le checkpointing incrémental et l'affinité d'hôte pour faire passer l'état à plusieurs téraoctets, ce que le site web prétend être éprouvé à grande échelle (par exemple, LinkedIn traite des milliards de messages par jour).
Tarification et positionnement sur le marché
Apache Samza est entièrement gratuit et open source sous licence Apache 2.0. Il n'y a pas de niveaux payants ou d'éditions entreprise — c'est un projet piloté par la communauté. La tarification n'est pas publiquement listée sur le site web au-delà du fait qu'il est open source, mais vous encourrez des coûts d'infrastructure pour exécuter vos propres clusters. Dans le paysage concurrentiel du traitement de flux, Samza rivalise directement avec Apache Flink et Kafka Streams. Contrairement à Flink, qui met l'accent sur le traitement du temps d'événement et une couche SQL plus riche, Samza brille par son intégration étroite avec Kafka et son déploiement enfichable. Kafka Streams est plus léger et plus facile à intégrer, mais Samza offre une gestion d'état plus robuste et un isolement via des conteneurs de traitement séparés. Samza est le mieux adapté aux équipes déjà investies dans l'écosystème Hadoop (YARN) ou à celles qui ont besoin de traiter des flux massifs avec un état déterministe. Il est moins idéal pour les petits projets ou les équipes sans une solide expertise en Java/Scala.
Points forts, limites et verdict final
Points forts : Apache Samza est mature, ayant été éprouvé chez LinkedIn et d'autres grandes entreprises. Ses capacités de faible latence et de haut débit sont bien documentées. L'architecture enfichable signifie que vous pouvez échanger les systèmes de stockage et de messagerie sous-jacents sans réécrire votre logique de traitement. La prise en charge de multiples API (DSL, SQL, Beam) offre une flexibilité selon les préférences des développeurs. Le déploiement sur YARN ou Kubernetes s'aligne avec les pratiques d'infrastructure modernes. L'activité de la communauté est modérée — la dernière version stable (1.8.0) est sortie en janvier 2023, et le blog montre des mises à jour régulières.
Limites : La courbe d'apprentissage abrupte est le plus grand inconvénient. Le framework suppose une familiarité avec les systèmes distribués, Java et les concepts de traitement de flux. La documentation, bien que complète, peut être dense et manque de tutoriels adaptés aux débutants au-delà du Quick Start. Il n'y a pas de bac à sable hébergé dans le cloud pour tester sans configuration. Comparé à Flink, le support SQL de Samza est moins sophistiqué, et sa cohérence d'API entre les langues est limitée aux langages JVM. De plus, l'écosystème autour de la surveillance et du débogage n'est pas aussi riche que celui des services gérés.
Recommandation : Je recommanderais Apache Samza aux équipes d'ingénierie qui ont besoin d'un framework de traitement de flux fiable et haute performance pour une utilisation en production, surtout si elles utilisent déjà Kafka et YARN/Kubernetes. C'est aussi un bon choix pour les applications étatiques qui nécessitent un checkpointing incrémental à l'échelle du téraoctet. Si vous êtes un développeur solo ou une petite équipe cherchant un prototypage rapide, envisagez Apache Flink ou Kafka Streams pour une prise en main plus douce. Dans l'ensemble, Samza est un cheval de bataille open source solide pour des charges de travail sérieuses de traitement de flux.
Visitez Apache Samza sur https://samza.apache.org/ pour l'explorer par vous-même.










Commentaires