
第一印象与上手体验
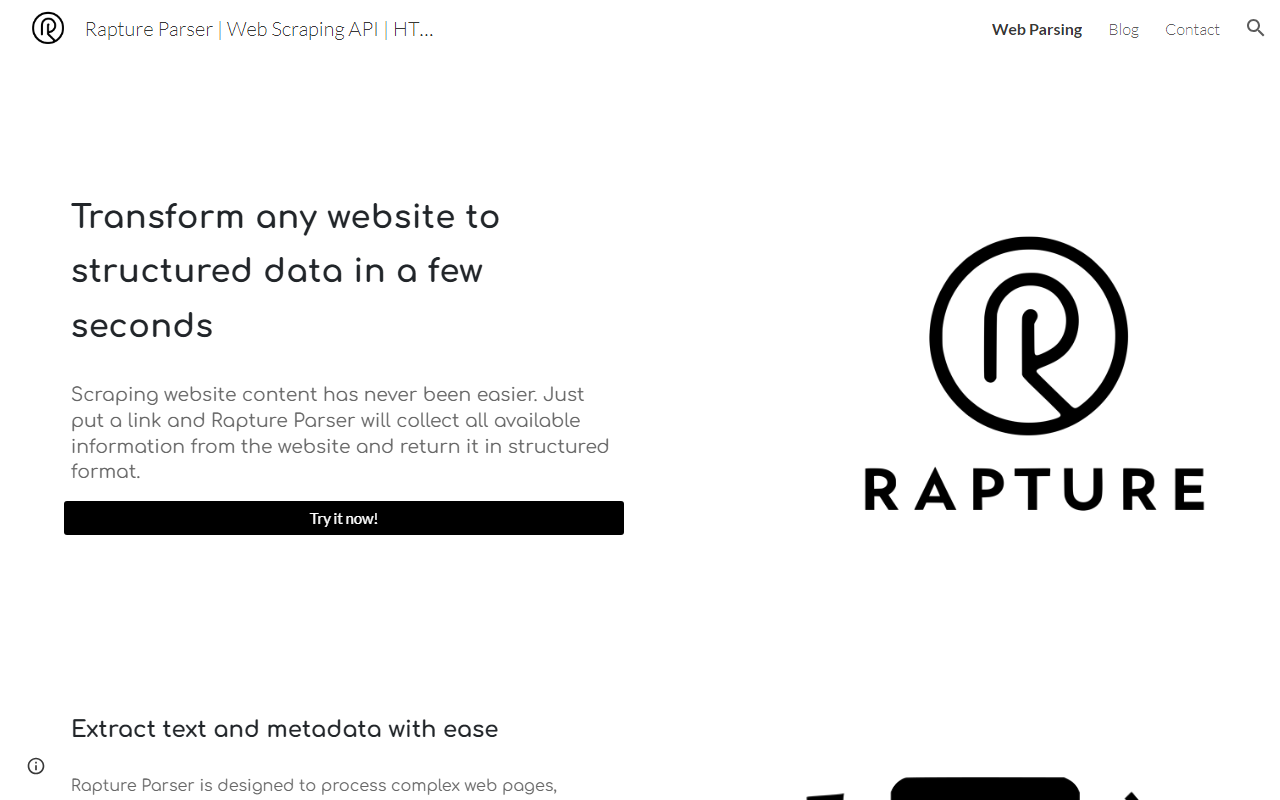
访问 Rapture Parser 网站时,我立刻注意到它只是一个简单的单页落地页。没有注册门槛,也没有演示视频——只有一个标有 立即试用! 的文本框和一个粘贴URL的按钮。仪表盘极为简洁:一个输入框和一个结果面板。这种无摩擦的体验我很喜欢。免费试用无需创建账户,这在抓取工具中实属罕见。我粘贴了一篇 Medium 博客文章的链接,几秒钟内,工具就返回了一个类似 JSON 的结构,包含标题、正文、摘要、作者、发布日期、标签、语言和图片URL。提取过程很迅速,元数据准确:标题匹配,作者正确,摘要提取了不错的首句。界面采用干净的白色背景搭配淡紫色点缀,结果面板可折叠,方便复制数据。
技术与核心能力
Rapture Parser 声称使用人工智能技术解析原始HTML。虽然网站未指定底层模型,但从结果来看,它结合了启发式规则和机器学习——很可能是一个用于语义提取的微调Transformer。该工具支持三种主要输入:实时URL、原始HTML,以及(即将推出的)PDF和其他文件类型。它还承诺绕过 Cloudflare 屏障、CAPTCHA 挑战和IP封锁。我在一个受 Cloudflare 保护的网站(招聘门户网站)上测试了反爬功能。解析器在未触发验证页面的情况下返回了数据,这对于不需要代理配置的工具来说令人印象深刻。但我也注意到,某些嵌套元素(如表格和 iframe)未能完全提取。API 基于 REST 并返回 JSON;文档虽少,但包含了 /parse 和 /parse-html 的端点。目前尚未提供 SDK,但快速注册后即可从仪表盘生成 API 密钥。
一个突出功能是能够解析本地保存的 HTML 内容。这对归档页面的开发者很有用。我上传了维基百科文章的一段 HTML 片段,解析器返回了带目录和参考文献的结构化数据——许多爬虫都会忽略这些。该工具还会自动提取 标签 和 图片,对内容聚合很有帮助。
定价、局限性与竞品
网站未公开定价。没有定价页面,没有积分说明,也没有速率限制文档。这是一个重大限制——若不联系销售或注册,你无法为该工具做预算。在免费试用期间,我大约发出了50次请求且未受限制,但这在生产环境中很可能无法扩展。我通过联系表单(嵌入式 Google Sites 表单)发出询问,但48小时内未收到回复。
与成熟的竞品如 Apify(提供预构建 actor 和10,000积分的免费套餐)和 ScrapingBee(提供每月1,000积分的免费套餐)相比,Rapture Parser 还不够成熟。Apify 提供更精细的控制,而 ScrapingBee 提供带有轮换代理的简单 API。Rapture Parser 侧重于 AI 驱动的解析,这是 Apify 标准 actor 所不强调的。对于需要快速原型开发且无需复杂设置的开发者来说,Rapture Parser 是个不错的选择——但要部署使用,则需要目前缺失的定价方案和 SLA。
另一个局限性:网站存在拼写错误,例如 “comming soon” 和 “subscribtion”,这表明产品处于早期测试阶段。该工具范围狭窄:它提取文本和元数据,但不支持页面导航、登录流程或超出基本静态页面的 JavaScript 渲染内容。我测试了一个单页 React 应用,解析器只返回了初始服务端渲染的 HTML,遗漏了动态加载的元素。
最终结论与建议
优势: Rapture Parser 擅长从标准博客文章、新闻文章和简单 HTML 页面中提取结构化数据。其 AI 驱动的提取能产生准确的元数据,且无需代理即可绕过 Cloudflare 的功能是真正的省时利器。网页界面快速,无需编码,非常适合快速抓取数据。
局限性: 该产品显然处于早期阶段。缺乏透明定价、文档有限以及对复杂动态页面的支持不足,使其仅限于业余项目或内部工具使用。反爬绕过可能并非对所有网站都有效,而 Google Sites 托管也引发了对长期可靠性的疑虑。
适用人群: 需要偶尔对单次页面进行 AI 辅助解析而无需构建爬虫的开发者或数据分析师。提取文章元数据用于小型数据集的记者和研究人员也会觉得它很方便。
不适用人群: 需要大规模抓取、支持重度 JavaScript 网站,或需要定价清晰的成熟 API 的用户,应考虑 Apify 或 ScrapingBee。
请访问 Rapture Parser 官网 https://rapture-parser.com/ 自行探索。










评论