
Premières impressions et prise en main
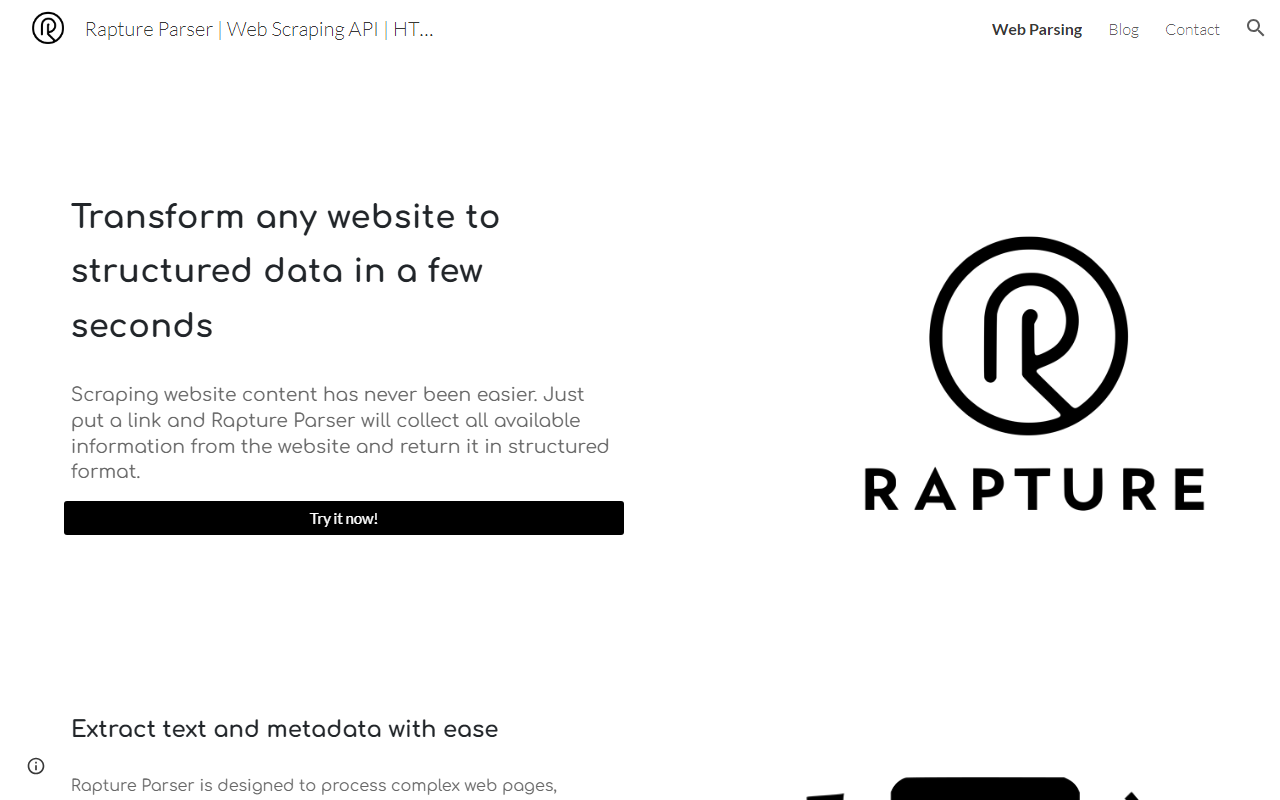
En visitant le site Web de Rapture Parser, je remarque immédiatement une landing page simple, d'une seule page. Il n'y a pas de mur d'inscription ni de vidéo de démonstration — juste une zone de texte intitulée Essayez maintenant ! et un bouton pour coller une URL. Le tableau de bord est minimal : un seul champ de saisie et un panneau de résultats. J'apprécie l'absence de friction. Aucune création de compte n'est requise pour l'essai gratuit, ce qui est rare parmi les outils de scraping. Je colle un lien vers un article de blog Medium, et en quelques secondes, l'outil renvoie une structure de type JSON contenant le titre, le texte, le résumé, l'auteur, la date de publication, les balises, la langue et les URL des images. L'extraction était rapide et les métadonnées étaient précises : le titre correspondait, l'auteur était correct, et le résumé a extrait une phrase d'ouverture correcte. L'interface utilise un fond blanc épuré avec de subtils accents violets, et le panneau de résultats est pliable, ce qui facilite la copie des données.
Technologie et capacités principales
Rapture Parser prétend utiliser des techniques d'intelligence artificielle pour analyser le HTML brut. Bien que le site Web ne précise pas le modèle sous-jacent, les résultats suggèrent une combinaison d'heuristiques et d'apprentissage automatique — probablement un transformateur affiné pour l'extraction sémantique. L'outil prend en charge trois entrées principales : une URL en direct, du HTML brut, et — bientôt — des fichiers PDF et d'autres types. Il promet également de contourner les barrières Cloudflare, les défis CAPTCHA et le blocage IP. J'ai testé la fonction anti-scraping sur un site protégé par Cloudflare (un portail d'offres d'emploi). Le parseur a renvoyé les données sans déclencher la page de défi, ce qui est impressionnant pour un outil ne nécessitant pas de configuration de proxy. Cependant, j'ai remarqué que certains éléments imbriqués, comme les tableaux et les iframes, n'étaient pas entièrement extraits. L'API est basée sur REST et renvoie du JSON ; la documentation est minimale mais inclut des endpoints pour /parse et /parse-html. Il n'y a pas encore de SDK, mais la clé API peut être générée depuis le tableau de bord après une inscription rapide.
Une fonctionnalité remarquable est la possibilité d'analyser du contenu HTML que vous avez déjà sauvegardé localement. C'est utile pour les développeurs qui archivent des pages. J'ai téléchargé un extrait HTML d'un article Wikipédia, et le parseur a renvoyé des données structurées avec une table des matières et des références — ce que de nombreux scraper omettent. L'outil extrait également les balises et les images automatiquement, ce qui est utile pour l'agrégation de contenu.
Tarification, limites et concurrents
Les tarifs ne sont pas listés publiquement sur le site Web. Il n'y a pas de page de tarification, aucune mention de crédits, et aucune documentation sur les limites de taux. Il s'agit d'une limitation importante — vous ne pouvez pas établir un budget pour l'outil sans contacter le service commercial ou vous inscrire. Durant mon essai gratuit, j'ai effectué environ 50 requêtes sans limitation, mais cela ne passera probablement pas à l'échelle pour une utilisation en production. J'ai contacté via le formulaire de contact (un formulaire intégré Google Sites) mais n'ai reçu aucune réponse dans les 48 heures.
Comparé à des concurrents établis comme Apify (qui propose des acteurs pré-construits et un niveau gratuit avec 10 000 crédits) et ScrapingBee (avec un niveau gratuit de 1 000 crédits mensuels), Rapture Parser est moins mature. Apify offre un contrôle plus granulaire, tandis que ScrapingBee propose une API simple avec des proxies tournants. Rapture Parser se concentre sur le parsing basé sur l'IA, ce que les acteurs standard d'Apify ne mettent pas en avant. Pour un développeur ayant besoin de prototypage rapide sans configuration complexe, Rapture Parser est une option décente — mais pour le déploiement, vous auriez besoin d'un plan tarifaire et d'un SLA qui sont actuellement absents.
Une autre limite : le site Web contient des fautes d'orthographe, comme « comming soon » et « subscribtion », ce qui suggère que le produit est en bêta précoce. Le périmètre de l'outil est restreint : il extrait du texte et des métadonnées mais ne prend pas en charge la navigation entre pages, les flux de connexion, ou le contenu rendu par JavaScript au-delà des pages statiques de base. J'ai testé une application React à page unique, et le parseur n'a renvoyé que le HTML initial rendu par le serveur, manquant les éléments chargés dynamiquement.
Verdict final et recommandations
Points forts : Rapture Parser excelle dans l'extraction de données structurées à partir d'articles de blog standard, d'articles de presse et de pages HTML simples. Son extraction basée sur l'IA produit des métadonnées précises, et la capacité de contourner Cloudflare sans proxy est un véritable gain de temps. L'interface Web est rapide et ne nécessite aucun codage, ce qui la rend idéale pour des collectes de données rapides.
Limites : Le produit est clairement à un stade précoce. Le manque de tarification transparente, une documentation limitée, et l'absence de support pour les pages dynamiques complexes limitent son utilisation à des projets personnels ou à des outils internes. Le contournement anti-scraping peut ne pas fonctionner sur tous les sites, et l'hébergement sur Google Sites soulève des questions sur la fiabilité à long terme.
À qui s'adresse-t-il : Les développeurs et analystes de données qui ont besoin d'un parsing occasionnel assisté par IA de pages uniques sans construire de scraper. Les journalistes et chercheurs extrayant des métadonnées d'articles pour de petits jeux de données le trouveront également utile.
Qui devrait chercher ailleurs : Quiconque a besoin de scraping à volume élevé, de support pour les sites lourds en JavaScript, ou d'une API prête pour la production avec une tarification claire devrait plutôt envisager Apify ou ScrapingBee.
Visitez Rapture Parser sur https://rapture-parser.com/ pour l'explorer par vous-même.










Commentaires