
第一印象とオンボーディング
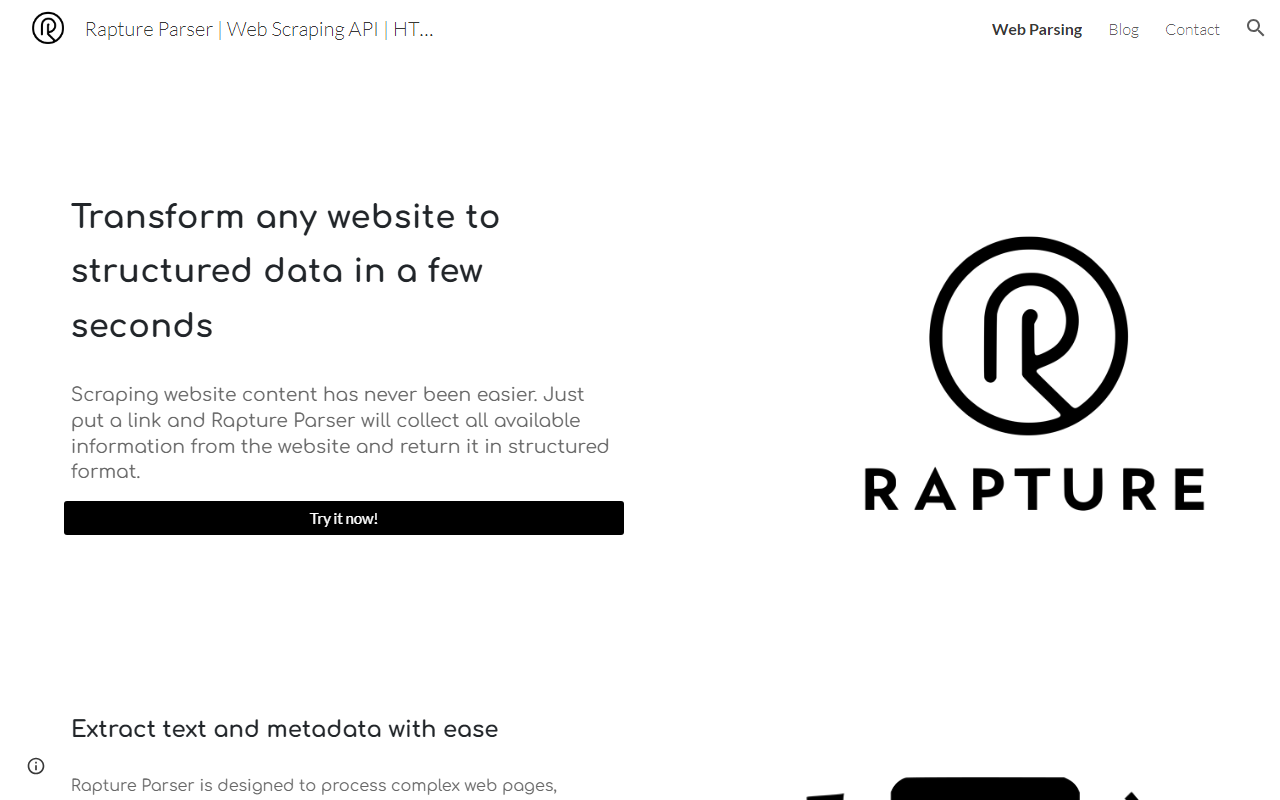
Rapture ParserのWebサイトにアクセスすると、シンプルな1ページのランディングページが表示されます。サインアップの壁やデモ動画はなく、「Try it now!」とラベル付けされたテキストボックスと、URLを貼り付けるボタンがあるだけです。ダッシュボードは最小限で、1つの入力フィールドと結果パネルで構成されています。摩擦(フリクション)がない点が気に入りました。無料トライアルではアカウント作成が不要で、これはスクレイピングツールとしては珍しいです。Mediumのブログ記事のリンクを貼り付けると、数秒以内にJSON形式の構造が返ってきました。タイトル、テキスト、要約、著者、公開日、タグ、言語、画像URLが含まれています。抽出は非常にスピーディーで、メタデータも正確でした。タイトルは一致し、著者は正しく、要約も適切な冒頭文を抽出していました。インターフェースは清潔感のある白い背景に微妙なパープルのアクセントカラーを使用しており、結果パネルは折りたたみ可能で、データをコピーしやすくなっています。
技術と中核機能
Rapture Parserは、人工知能技術を使用して生のHTMLを解析すると主張しています。Webサイトでは基盤となるモデルは特定されていませんが、結果からヒューリスティクスと機械学習の組み合わせ(おそらくセマンティック抽出用に微調整されたTransformer)であることが示唆されます。このツールは、ライブURL、生のHTML、そして近々PDFやその他のファイル形式という3つの主要な入力をサポートしています。また、Cloudflareの障壁やCAPTCHAチャレンジ、IPブロックを回避することも約束しています。私はCloudflareで保護されたサイト(求人情報ポータル)でアンチスクレイピング機能をテストしました。パーサーは、チャレンジページをトリガーすることなくデータを返しました。これは、プロキシ設定を必要としないツールとしては印象的です。ただし、テーブルやiframeなどのネストされた要素の中には完全に抽出されなかったものもありました。APIはRESTベースでJSONを返します。ドキュメントは最小限ですが、/parseおよび/parse-htmlのエンドポイントが含まれています。まだSDKはありませんが、簡単な登録後にダッシュボードからAPIキーを生成できます。
特筆すべき機能の1つは、ローカルに保存してあるHTMLコンテンツを解析できることです。これはページをアーカイブする開発者にとって便利です。Wikipediaの記事からHTMLスニペットをアップロードしたところ、パーサーは目次と参考文献を構造化データとして返しました。多くのスクレイパーが見逃す部分です。また、ツールはタグと画像を自動的に抽出するため、コンテンツの集約に役立ちます。
価格、制限、競合他社
価格はWebサイトに公開されていません。価格ページも、クレジットに関する言及も、レート制限のドキュメントもありません。これは大きな制限です。営業に連絡するか、サインアップしない限り、ツールの予算を計画できません。無料トライアル中に約50リクエストを制限なく行いましたが、これは本番環境ではスケールしないでしょう。問い合わせフォーム(Google Sitesに埋め込まれたフォーム)から連絡しましたが、48時間以内に返信はありませんでした。
確立された競合他社であるApify(事前構築済みアクターと1万クレジットの無料枠を提供)やScrapingBee(月1,000クレジットの無料枠を提供)と比較すると、Rapture Parserは成熟度が低いです。Apifyはより細かい制御を提供し、ScrapingBeeはローテーションプロキシを使用したシンプルなAPIを提供します。Rapture ParserはAI駆動の解析に重点を置いており、Apifyの標準アクターはこれを重視していません。複雑な設定なしに迅速なプロトタイピングを必要とする開発者にとって、Rapture Parserは適切な選択肢です。ただし、デプロイには、現在欠けている価格プランとSLAが必要になります。
もう1つの制限として、Webサイトには「comming soon」や「subscribtion」といったスペルミスがあり、製品が初期ベータ版であることが示唆されます。ツールの範囲は狭く、テキストとメタデータを抽出しますが、ページナビゲーション、ログインフロー、または基本的な静的ページを超えたJavaScriptレンダリングコンテンツはサポートしていません。シングルページReactアプリをテストしたところ、パーサーは初期のサーバーサイドレンダリングHTMLのみを返し、動的に読み込まれる要素は欠落していました。
最終評価と推奨事項
強み: Rapture Parserは、標準的なブログ記事、ニュース記事、シンプルなHTMLページから構造化データを抽出するのに優れています。AI搭載の抽出により正確なメタデータが得られ、プロキシなしでCloudflareを回避できるのは本当に時間の節約になります。Webインターフェースは高速でコーディング不要のため、データを素早く取得するのに最適です。
制限事項: この製品は明らかに初期段階です。透明性のある価格設定の欠如、限られたドキュメント、複雑な動的ページのサポートがないため、趣味のプロジェクトや内部ツールに使用が制限されます。アンチスクレイピングのバイパスはすべてのサイトで機能するとは限らず、Google Sitesでのホスティングは長期的な信頼性に疑問を投げかけます。
こんな方におすすめ: スクレイパーを構築せずに、AI支援で単発のページをたまに解析する必要がある開発者やデータアナリスト。小規模なデータセットのために記事メタデータを抽出するジャーナリストや研究者にも便利です。
代替手段を検討すべき方: 大量のスクレイピング、JavaScriptヘビーなサイトのサポート、明確な価格設定のある本番環境対応APIが必要な方は、代わりにApifyまたはScrapingBeeを検討してください。
ぜひ自分で試してみてください。Rapture Parser(https://rapture-parser.com/)にアクセスしてください。










コメント