

Apache Tika 的功能与重要性
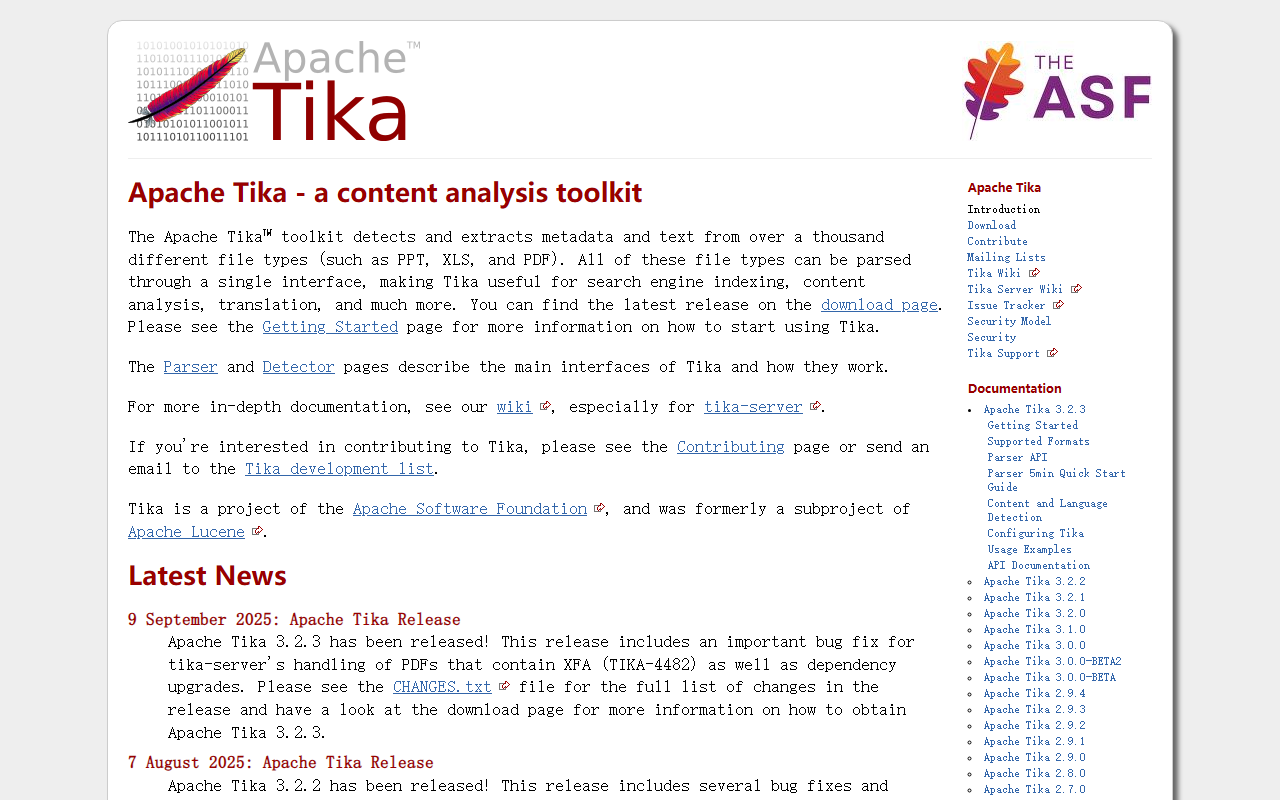
访问 Apache Tika 官方网站时,首先让我印象深刻的是这个工具包支持的文件格式数量之多——超过一千种,包括 PPT、XLS、PDF 等等。Apache Tika 并不是一个面向消费者的应用,没有花哨的仪表盘;它是一个专为需要程序化内容分析的开发者设计的库和服务器。其核心功能是,通过单一统一接口,从各种不同文档格式中提取结构化文本和元数据,解决了这一杂乱问题。无论您是在构建搜索引擎索引、自动化翻译流水线,还是进行文档分类,Tika 都能抽象掉处理每种格式特性的复杂性。该项目由 Apache 软件基金会托管,最初是 Apache Lucene 的子项目,这使其在开源生态系统中拥有强大的血统。
技术深入探讨:架构与模型
在测试免费层级(整个项目开源且免费)时,我发现文档很详尽,但需要熟悉 Java 和 Maven。Tika 提供两个主要接口:Parser(解析器)和 Detector(检测器)。Parser 负责文本提取,而 Detector 基于魔法字节或其他启发式方法识别文件类型。在底层,Tika 利用各种解析器处理不同格式——Apache POI 用于 Office 文档,PDFBox 用于 PDF,Tesseract 用于 OCR 等。这里没有专有的 AI 模型;相反,Tika 使用成熟的基于规则和统计的方法,最新版本(截至 2026 年 3 月的 3.3.0)改进了 zip 解析和从 PDF 中提取 JavaScript。最新版本需要 Java 11 或更高版本(3.x 分支),该工具包可以作为独立 JAR、REST 服务器(tika-server)使用,或通过 Maven 集成。API 可用性很强:您可以通过 Java、Python(通过 Jython 或子进程)调用它,或者如果使用 tika-server,任何支持 HTTP 的语言都可以。网站上没有公开列出定价——因为它免费且开源,基于 Apache License 2.0 许可。
市场定位与替代方案
与 Amazon Textract 或 Google Document AI 等商业替代品相比,Apache Tika 更具可定制性和成本效益,但缺乏内置的机器学习功能,例如表单提取或手写识别。与云服务不同,Tika 让您完全控制解析流水线,并且可以完全离线运行,这对敏感数据至关重要。在开源领域,像 Apache Tika 这样的库与 Stanza(用于 NLP)和单独的 Apache PDFBox 竞争,但 Tika 的优势在于其一体化的文件类型检测和文本提取方法。我还注意到,Tika 的 2.x 分支已于 2025 年 4 月停止维护,3.x 分支现在需要 Java 11。这意味着仍在使用 Java 8 的用户必须升级。该项目由志愿者社区维护,定期发布版本——最新消息部分显示每月更新,表明开发活跃。此工具最适合构建内容管理系统、搜索引擎或数据管道的开发者,他们需要可靠的提取且无需按文档付费。对于希望即点即用解决方案的非开发者,或需要基于 AI 的高级理解的任务,它不太理想。
优势与局限
Apache Tika 的一个真正优势是其无与伦比的文件类型支持和接口的一致性。我测试了从包含表格和图像的多部分 PDF 中提取文本;结果很干净,尽管 OCR 质量取决于底层 Tesseract 的安装。该工具包还提供许多云服务省略的详细元数据(日期、作者、页数)。另一个主要优点:它完全离线运行,因此没有数据离开您的基础设施。然而,也存在一些实际限制。首先,学习曲线陡峭——文档假定您知道如何构建 Java 项目。其次,对于非常大的文件,性能可能较慢,并且内存使用率高,因为解析器将完整文档加载到内存中。第三,没有内置的自然语言处理或语义理解;Tika 提取原始文本但不分析含义。对于需要摘要或分类的用户,需要将输出导入到单独的 NLP 工具中。该项目还缺乏图形用户界面;所有交互都是程序化的,或通过 tika-server 的 REST 端点进行,这需要设置。
总之,Apache Tika 是一个成熟、可靠的规模化文本提取工具。我推荐给需要在自动化流水线中处理多种文档类型的后端工程师和 DevOps 团队。如果您是一位数据科学家,希望快速从文档中提取文本进行分析,Tika 结合 Python 的 tika 库是一个可靠的选择。但如果您想要一个开箱即用的 AI 阅读助手,请另寻他处。请访问 Apache Tika 官网 https://tika.apache.org/ 自行探索。










评论