

Ce que fait Apache Tika et pourquoi c'est important
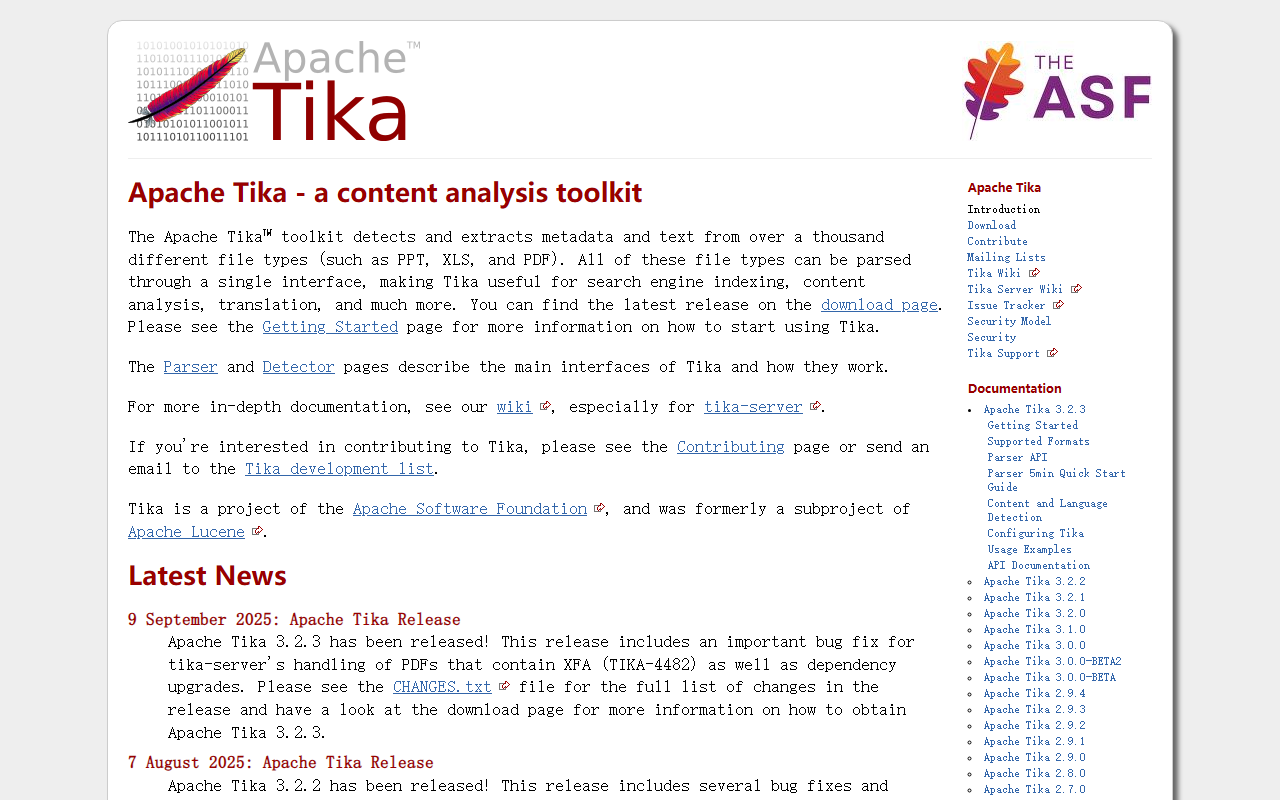
En visitant le site officiel d'Apache Tika, la première chose qui m'a frappé est le volume impressionnant de types de fichiers pris en charge par cette boîte à outils — plus d'un millier, dont PPT, XLS, PDF et bien d'autres. Apache Tika n'est pas une application destinée aux consommateurs avec un tableau de bord clinquant ; c'est une bibliothèque et un serveur conçus pour les développeurs ayant besoin d'analyse de contenu programmatique. À la base, Tika résout le problème complexe de l'extraction de texte structuré et de métadonnées à partir de formats de documents disparates en utilisant une interface unique et unifiée. Que vous construisiez un index de moteur de recherche, automatisiez des pipelines de traduction ou effectuiez une classification de documents, Tika abstrait la complexité de la gestion des particularités de chaque format. Le projet est hébergé par The Apache Software Foundation et était à l'origine un sous-projet d'Apache Lucene, ce qui lui confère un solide pedigree dans l'écosystème open-source.
Plongée technique : Architecture et modèles
En testant le niveau gratuit (l'ensemble du projet est open-source et gratuit), j'ai trouvé la documentation complète, même si elle suppose une familiarité avec Java et Maven. Tika propose deux interfaces principales : le Parser et le Detector. Le Parser gère l'extraction de texte, tandis que le Detector identifie les types de fichiers en se basant sur des octets magiques ou d'autres heuristiques. Sous le capot, Tika utilise divers analyseurs pour différents formats — Apache POI pour les documents Office, PDFBox pour les PDF et Tesseract pour l'OCR, entre autres. Il n'y a pas de modèle d'IA propriétaire ici ; Tika utilise plutôt des méthodes bien établies basées sur des règles et des statistiques, les versions récentes (3.3.0 en date de mars 2026) améliorant l'analyse des fichiers zip et l'extraction de JavaScript à partir des PDF. Les dernières versions nécessitent Java 11 ou supérieur (branche 3.x), et la boîte à outils peut être utilisée comme un JAR autonome, un serveur REST (tika-server) ou intégrée via Maven. La disponibilité de l'API est robuste : vous pouvez l'appeler depuis Java, Python (via Jython ou un sous-processus) ou tout langage qui parle HTTP si vous utilisez tika-server. Les prix ne sont pas listés publiquement sur le site — car c'est gratuit et open-source, sous licence Apache License 2.0.
Positionnement sur le marché et alternatives
Comparé à des alternatives commerciales comme Amazon Textract ou Google Document AI, Apache Tika est bien plus personnalisable et rentable, mais il manque d'apprentissage automatique intégré pour des choses comme l'extraction de formulaires ou la reconnaissance d'écriture manuscrite. Contrairement aux services cloud, Tika vous donne un contrôle total sur les pipelines d'analyse et peut fonctionner entièrement hors ligne, ce qui est critique pour les données sensibles. Dans le domaine open-source, des bibliothèques comme Apache Tika concurrencent Stanza (pour le NLP) et Apache PDFBox seul, mais la force de Tika réside dans son approche tout-en-un pour la détection de types de fichiers et l'extraction de texte. J'ai également noté que la branche 2.x de Tika a atteint sa fin de vie en avril 2025, la branche 3.x nécessitant désormais Java 11. Cela signifie que les utilisateurs encore sur Java 8 doivent effectuer une mise à niveau. Le projet est maintenu par une communauté de bénévoles, avec des versions régulières — la section des dernières nouvelles montre des mises à jour mensuelles, ce qui indique un développement actif. Cet outil est le mieux adapté aux développeurs qui construisent des systèmes de gestion de contenu, des moteurs de recherche ou des pipelines de données ayant besoin d'une extraction fiable sans coût par document. Il est moins idéal pour les non-développeurs qui souhaitent une solution clé en main ou pour des tâches nécessitant une compréhension avancée basée sur l'IA.
Forces et limites
Un véritable avantage d'Apache Tika est le support inégalé de types de fichiers et la cohérence de son interface. J'ai testé l'extraction de texte à partir d'un PDF multipartite contenant des tableaux et des images ; le résultat était propre, même si la qualité de l'OCR dépend de l'installation sous-jacente de Tesseract. La boîte à outils fournit également des métadonnées détaillées (dates, auteurs, nombre de pages) que de nombreux services cloud omettent. Un autre gros plus : il fonctionne entièrement hors ligne, donc aucune donnée ne quitte votre infrastructure. Cependant, il existe de réelles limitations. Premièrement, la courbe d'apprentissage est abrupte — la documentation suppose que vous savez construire des projets Java. Deuxièmement, les performances peuvent être lentes pour les très gros fichiers, et l'utilisation de la mémoire est élevée car les analyseurs chargent les documents complets en mémoire. Troisièmement, il n'y a pas de traitement du langage naturel intégré ni de compréhension sémantique ; Tika extrait le texte brut mais n'analyse pas le sens. Pour quiconque a besoin de résumé ou de classification, vous devrez diriger la sortie vers un outil NLP séparé. Le projet manque également d'interface graphique ; toutes les interactions sont programmatiques ou via le point d'accès REST de tika-server, ce qui nécessite une configuration.
En conclusion, Apache Tika est un cheval de bataille mature et fiable pour l'extraction de texte à grande échelle. Je le recommande aux ingénieurs backend et aux équipes DevOps qui ont besoin de traiter divers types de documents dans des pipelines automatisés. Si vous êtes un data scientist cherchant un moyen rapide d'extraire du texte de documents pour analyse, Tika combiné avec la bibliothèque tika de Python est un choix solide. Mais si vous voulez un assistant de lecture prêt à l'emploi avec IA, cherchez ailleurs. Visitez Apache Tika sur https://tika.apache.org/ pour l'explorer par vous-même.










Commentaires