

Apache Tika の機能とその重要性
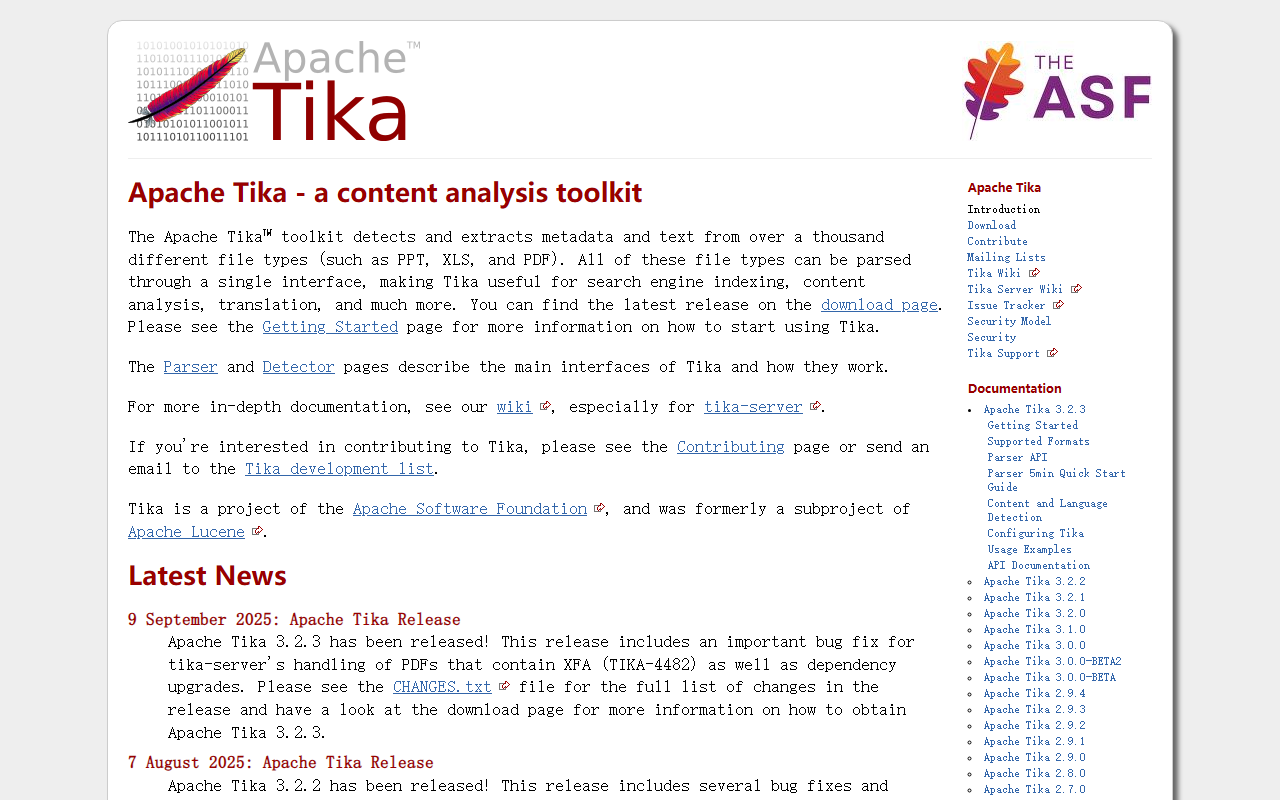
公式の Apache Tika ウェブサイトを訪れたとき、最初に驚いたのは、このツールキットがサポートするファイル形式の膨大さです。PPT、XLS、PDF など、1000以上の形式に対応しています。Apache Tika は、派手なダッシュボードを備えた消費者向けアプリケーションではありません。これは、プログラムによるコンテンツ分析を必要とする開発者向けに設計されたライブラリおよびサーバーです。Tika の核心は、単一の統一インターフェースを使用して、異種のドキュメント形式から構造化されたテキストとメタデータを抽出するという厄介な問題を解決することです。検索エンジンのインデックスを構築する場合、翻訳パイプラインを自動化する場合、またはドキュメント分類を実行する場合でも、Tika は各形式の特殊性を処理する複雑さを抽象化します。このプロジェクトは Apache Software Foundation がホストしており、元々は Apache Lucene のサブプロジェクトでした。このことが、オープンソースエコシステムにおける強力なバックグラウンドを与えています。
技術的な深掘り: アーキテクチャとモデル
無料版(プロジェクト全体がオープンソースで無料)をテストした際、ドキュメントは詳細でしたが、Java と Maven の知識を前提としていることに気付きました。Tika は Parser と Detector という 2 つの主要なインターフェースを提供します。Parser はテキスト抽出を担当し、Detector はマジックバイトやその他のヒューリスティックに基づいてファイルタイプを識別します。内部的には、Tika はさまざまな形式に対してさまざまなパーサーを活用しています。Office ドキュメント用の Apache POI、PDF 用の PDFBox、OCR 用の Tesseract などです。ここには独自の AI モデルはありません。代わりに、Tika は確立されたルールベースおよび統計的手法を使用しており、最近のバージョン(2026年3月時点で3.3.0)では、zip 解析と PDF からの JavaScript 抽出が改善されています。最新リリースには Java 11 以降(3.x ブランチ)が必要であり、ツールキットはスタンドアロン JAR、REST サーバー(tika-server)、または Maven を介した統合として使用できます。API の利用可能性は堅牢です。Java、Python(Jython またはサブプロセス経由)、または tika-server を使用する場合は HTTP を話す任意の言語から呼び出すことができます。価格はウェブサイトに公開されていません。無料でオープンソースであり、Apache License 2.0 の下でライセンスされているからです。
市場での位置づけと代替ツール
Amazon Textract や Google Document AI といった商用の代替製品と比較すると、Apache Tika ははるかにカスタマイズ可能でコスト効率に優れています。しかし、フォーム抽出や手書き文字認識などのための組み込みの機械学習機能は欠けています。クラウドサービスとは異なり、Tika は解析パイプラインを完全に制御でき、完全にオフラインで動作するため、機密データにとって重要です。オープンソースの分野では、Apache Tika は Stanza(NLP 用)や Apache PDFBox 単体と競合しますが、Tika の強みはファイルタイプの検出とテキスト抽出におけるオールインワンのアプローチです。また、Tika の 2.x ブランチは 2025 年 4 月にサポート終了となり、3.x ブランチでは Java 11 が必要になったことにも気付きました。これは、まだ Java 8 を使用しているユーザーはアップグレードしなければならないことを意味します。プロジェクトはボランティアのコミュニティによってメンテナンスされており、定期的にリリースされています。最新ニュースセクションには毎月のアップデートが表示されており、活発な開発が行われていることを示しています。このツールは、ドキュメントあたりのコストなしで信頼性の高い抽出を必要とする、コンテンツ管理システム、検索エンジン、またはデータパイプラインを構築する開発者に最適です。ポイントアンドクリックのソリューションを求める非開発者や、高度な AI ベースの理解を必要とするタスクにはあまり適していません。
強みと制限
Apache Tika の真の強みは、比類のないファイル形式サポートとインターフェースの一貫性です。テーブルや画像を含むマルチパート PDF からテキスト抽出をテストしたところ、結果はクリーンでした。ただし、OCR の品質は基盤となる Tesseract のインストールに依存します。このツールキットは、多くのクラウドサービスが省略する詳細なメタデータ(日付、作成者、ページ数)も提供します。もう一つの大きな利点は、完全にオフラインで動作するため、データがインフラストラクチャから外部に出ないことです。しかし、実際の制限もあります。第一に、学習曲線が急勾配です。ドキュメントは Java プロジェクトの構築方法を知っていることを前提としています。第二に、非常に大きなファイルの場合、パフォーマンスが遅くなる可能性があり、パーサーがドキュメント全体をメモリにロードするため、メモリ使用量が高くなります。第三に、組み込みの自然言語処理や意味理解はありません。Tika は生のテキストを抽出しますが、意味を分析しません。要約や分類が必要な場合は、出力を別の NLP ツールにパイプする必要があります。また、プロジェクトにはグラフィカルユーザーインターフェースがなく、すべての操作はプログラムによるか、tika-server の REST エンドポイントを介して行われ、セットアップが必要です。
結論として、Apache Tika は大規模なテキスト抽出のための成熟した信頼性の高いワークホースです。自動化パイプラインで多様なドキュメントタイプを処理する必要があるバックエンドエンジニアや DevOps チームにお勧めします。分析のためにドキュメントからテキストをすばやく取得する方法を探しているデータサイエンティストであれば、Tika と Python の tika ライブラリを組み合わせることは堅実な選択です。ただし、AI を搭載したすぐに使える読書アシスタントが必要な場合は、別のツールを探してください。Apache Tika のウェブサイト https://tika.apache.org/ にアクセスして、ご自身で試してみてください。










コメント