

Apache Tika의 역할과 그 중요성
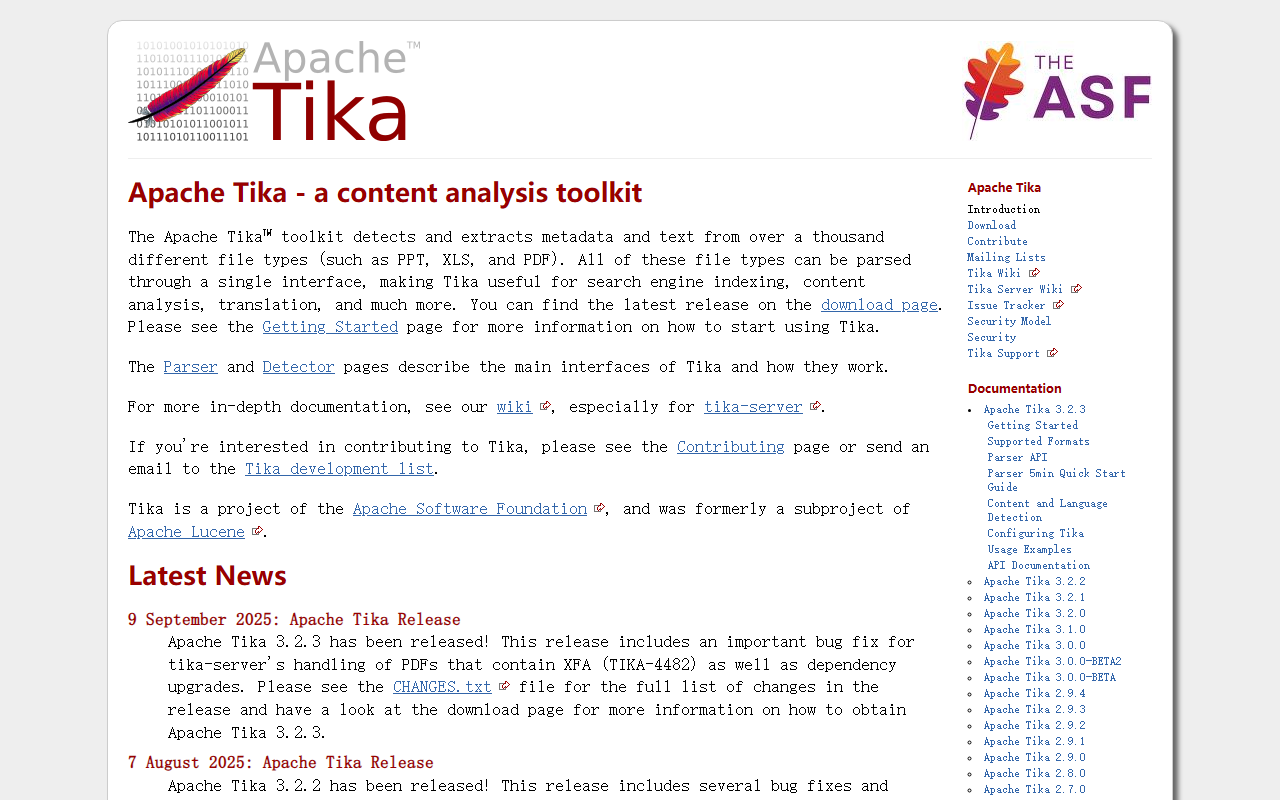
공식 Apache Tika 웹사이트를 방문했을 때 가장 먼저 눈에 띈 것은 이 툴킷이 지원하는 파일 형식의 방대한 양이었습니다. PPT, XLS, PDF 등 천 개 이상의 형식을 지원합니다. Apache Tika는 화려한 대시보드를 갖춘 소비자용 앱이 아니라 프로그래밍 방식의 콘텐츠 분석이 필요한 개발자를 위해 설계된 라이브러리이자 서버입니다. 핵심적으로 Tika는 단일 통합 인터페이스를 사용하여 다양한 문서 형식에서 구조화된 텍스트와 메타데이터를 추출하는 까다로운 문제를 해결합니다. 검색 엔진 인덱스를 구축하거나 번역 파이프라인을 자동화하거나 문서 분류를 수행하는 경우 Tika는 각 형식의 특성을 처리하는 복잡성을 추상화합니다. 이 프로젝트는 Apache Software Foundation에서 호스팅하며 원래 Apache Lucene의 하위 프로젝트였기 때문에 오픈소스 생태계에서 강력한 계보를 자랑합니다.
기술 심층 분석: 아키텍처 및 모델
무료 티어(전체 프로젝트는 오픈소스이며 무료)를 테스트할 때 문서화가 철저하다는 것을 알았지만 Java와 Maven에 대한 familiarity를 요구합니다. Tika는 Parser와 Detector라는 두 가지 주요 인터페이스를 제공합니다. Parser는 텍스트 추출을 처리하고 Detector는 매직 바이트나 기타 휴리스틱을 기반으로 파일 형식을 식별합니다. 내부적으로 Tika는 다양한 형식에 대해 각기 다른 파서를 활용합니다. Office 문서에는 Apache POI, PDF에는 PDFBox, OCR에는 Tesseract 등입니다. 독점 AI 모델은 없습니다. 대신 Tika는 잘 정립된 규칙 기반 및 통계적 방법을 사용하며, 최신 버전(2026년 3월 기준 3.3.0)에서는 zip 파싱과 PDF의 JavaScript 추출이 개선되었습니다. 최신 릴리스는 Java 11 이상(3.x 브랜치)을 요구하며 툴킷은 독립형 JAR, REST 서버(tika-server)로 사용하거나 Maven을 통해 통합할 수 있습니다. API 가용성은 강력합니다. Java, Python(Jython 또는 하위 프로세스를 통해), 또는 tika-server를 사용하는 경우 HTTP를 지원하는 모든 언어에서 호출할 수 있습니다. 가격은 웹사이트에 공개적으로 나와 있지 않습니다. Apache License 2.0에 따라 라이선스가 부여된 무료 오픈소스이기 때문입니다.
시장 위치 및 대안
Amazon Textract나 Google Document AI와 같은 상용 대안과 비교할 때 Apache Tika는 훨씬 더 사용자 정의가 가능하고 비용 효율적이지만 양식 추출이나 필기 인식과 같은 작업을 위한 내장 머신러닝이 부족합니다. 클라우드 서비스와 달리 Tika는 파싱 파이프라인을 완전히 제어할 수 있으며 완전히 오프라인으로 실행할 수 있어 민감한 데이터에 중요합니다. 오픈소스 공간에서 Apache Tika는 Stanza(NLP용)나 Apache PDFBox 단독과 경쟁하지만 Tika의 강점은 파일 형식 감지와 텍스트 추출에 대한 올인원 접근 방식입니다. 또한 Tika의 2.x 브랜치는 2025년 4월에 수명이 종료되었으며 3.x 브랜치는 이제 Java 11을 요구합니다. 이는 여전히 Java 8을 사용하는 사용자는 업그레이드해야 함을 의미합니다. 이 프로젝트는 자원봉사자 커뮤니티에서 유지 관리하며 정기적으로 릴리스됩니다. 최신 뉴스 섹션을 보면 월간 업데이트가 있어 활발한 개발이 진행 중임을 알 수 있습니다. 이 도구는 문서당 비용 없이 안정적인 추출이 필요한 콘텐츠 관리 시스템, 검색 엔진 또는 데이터 파이프라인을 구축하는 개발자에게 가장 적합합니다. 포인트 앤 클릭 솔루션을 원하는 비개발자나 고급 AI 기반 이해가 필요한 작업에는 덜 적합합니다.
강점과 한계
Apache Tika의 진정한 강점은 비교할 수 없는 파일 형식 지원과 일관된 인터페이스입니다. 표와 이미지가 포함된 다중 부분 PDF에서 텍스트를 추출해 보았는데 결과는 깨끗했지만 OCR 품질은 기본 Tesseract 설치에 따라 달라집니다. 또한 툴킷은 많은 클라우드 서비스에서 생략하는 상세한 메타데이터(날짜, 작성자, 페이지 수)를 제공합니다. 또 다른 큰 장점은 완전히 오프라인으로 작동하므로 데이터가 인프라를 벗어나지 않는다는 점입니다. 그러나 실제 한계도 있습니다. 첫째, 학습 곡선이 가파릅니다. 문서는 Java 프로젝트를 빌드하는 방법을 알고 있다고 가정합니다. 둘째, 매우 큰 파일의 경우 성능이 느릴 수 있으며 파서가 전체 문서를 메모리에 로드하기 때문에 메모리 사용량이 높습니다. 셋째, 내장된 자연어 처리나 의미 이해가 없습니다. Tika는 원시 텍스트를 추출하지만 의미를 분석하지는 않습니다. 요약이나 분류가 필요한 경우 출력을 별도의 NLP 도구에 전달해야 합니다. 또한 프로젝트에는 그래픽 사용자 인터페이스가 없습니다. 모든 상호 작용은 프로그래밍 방식이거나 tika-server의 REST 엔드포인트를 통해 이루어지며 설정이 필요합니다.
결론적으로 Apache Tika는 대규모 텍스트 추출을 위한 성숙하고 안정적인 작업 도구입니다. 자동화된 파이프라인에서 다양한 문서 유형을 처리해야 하는 백엔드 엔지니어와 DevOps 팀에 추천합니다. 분석을 위해 문서에서 텍스트를 빠르게 추출하려는 데이터 과학자라면 Tika와 Python의 tika 라이브러리를 조합하는 것이 좋은 선택입니다. 하지만 AI를 갖춘 즉시 사용 가능한 읽기 도우미를 원한다면 다른 곳을 보십시오. Apache Tika를 직접 살펴보려면 https://tika.apache.org/를 방문하십시오.










댓글